4.7.3. perf
perf 是
4.7.3.1. 语法说明
以下
usage: perf [--version] [--help] [OPTIONS] COMMAND [ARGS]
4.7.3.2. 参数选项说明
perf 支持
annotate
   作用:解析 perf record 生成的 perf.data 文件,显示被注释的代码。
archive
   作用:根据数据文件记录的 build-id,将所有被采样到的 elf 文件打包。利用此压缩包,可以再任何机器上分析数据文件中记录的采样数据。
bench
   作用: perf 中内置的 benchmark,目前包括两套针对调度器和内存管理子系统的 benchmark。
buildid-cache
   作用:管理 perf 的 buildid 缓存,每个 elf 文件都有一个独一无二的 buildid。 buildid 被 perf 用来关联性能数据与 elf 文件。
buildid-list
   作用:列出数据文件中记录的所有 buildid。
diff
   作用:对比两个数据文件的差异。能够给出每个符号(函数)在热点分析上的具体差异。
evlist
   作用:列出数据文件 perf.data 中所有性能事件。
inject
   作用:该工具读取 perf record 工具记录的事件流,并将其定向到标准输出。在被分析代码中的任何一点,都可以向事件流中注入其它事件。
kmem
   作用:针对内核内存( slab)子系统进行追踪测量的工具
kvm
   作用:用来追踪测试运行在 KVM 虚拟机上的 Guest OS。
list
   作用:列出当前系统支持的所有性能事件。包括硬件性能事件、软件性能事件以及检查点。
lock
   作用:分析内核中的锁信息,包括锁的争用情况,等待延迟等。
mem
   作用:内存存取情况
record
   作用:收集采样信息,并将其记录在数据文件中。随后可通过其它工具对数据文件进行分析。
report
   作用:读取 perf record 创建的数据文件,并给出热点分析结果。
sched
   作用:针对调度器子系统的分析工具。
script
   作用:执行 perl 或 python 写的功能扩展脚本、生成脚本框架、读取数据文件中的数据信息等。
stat
   作用:执行某个命令,收集特定进程的性能概况,包括 CPI、 Cache 丢失率等。
test
   作用: perf 对当前软硬件平台进行健全性测试,可用此工具测试当前的软硬件平台是否能支持 perf 的所有功能。
timechart
   作用:针对测试期间系统行为进行可视化的工具
top
   作用:类似于 linux 的 top 命令,对系统性能进行实时分析。
trace
   作用:关于 syscall 的工具。
probe
   作用:用于定义动态检查点。
全局性
perf list
   作用:查看当前系统支持的性能事件。
perf bench
   作用:对系统性能进行摸底。
perf test
   作用:对系统进行健全性测试
perf stat
   作用:对全局性能进行统计
全局
perf top
   作用:可以实时查看当前系统进程函数占用率情况。
perf probe
   作用:可以自定义动态事件。
特定
perf kmem
   作用:针对 slab 子系统性能分析。
perf kvm
   作用:针对 kvm 虚拟化分析。
perf lock
   作用:分析锁性能。
perf mem
   作用:分析内存 slab 性能。
perf sched
   作用:分析内核调度器性能。
perf trace
   作用:记录系统调用轨迹。
常用
可以
perf record
   作用:记录信息到 perf.data。
perf report
   作用:生成报告。
perf diff
   作用:对两个记录进行 diff。
perf evlist
   作用:列出记录的性能事件。
perf annotate
   作用:显示 perf.data 函数代码。
perf archive
   作用:将相关符号打包,方便在其它机器进行分析。
可视化
perf timechart record
   作用:记录事件。
perf timechart
   作用:生成 output.svg 文档。
4.7.3.3. 各项命令选项及其功能说明
perf 系统分析
命令:
root@buildroot:~# perf top
功能:
实时
打印输出:
  PerfTop:    1109 irqs/sec  kernel:58.4%  exact:  0.0% lost: 0/0 drop: 0/0 [4000Hz cycles],  (all, 8 CPUs)
-------------------------------------------------------------------------------------------------------------------------------------------------------------

     7.52%  perf              [.] 0x00000000000d7930
     5.45%  libc.so.6         [.] strchr
     5.23%  [kernel]          [k] format_decode
     5.15%  [kernel]          [k] number
     3.81%  [kernel]          [k] vsnprintf
     3.43%  [kernel]          [k] kallsyms_expand_symbol.constprop.0
     3.08%  [kernel]          [k] string
     2.16%  [kernel]          [k] module_get_kallsym
     2.03%  libc.so.6         [.] __libc_calloc
     1.60%  perf              [.] 0x00000000000e1974
字
1109 irqs/sec:中断
频率, 1109 次 / 秒。 kernel:内核
态 CPU 占用: 58.4%。 exact:表示
采样 事件 中 精确 匹配 硬件 计数器 的 事件 比例,0.0% 表示 所有 事件 均 被 准确 记录。 lost: 采样
过程 中 丢失 的 事件 数(此处 为 0 )。 drop: 内核
因 缓冲区 溢出 而 主动 丢弃 的 事件 数(此处 为 0 )
每
Overhead:代表
该 符号 的 性能 事件 在 所有 采样 中 的 比例,用 百分比 来 表示。 Shared:代表
该 函数 或 指令 所在 的 动态 共享 对象( Dynamic Shared Object),如 内核、进程 名、动态链接库 名、内核模块 名 等。 Object:代表
动态 共享 对象 的 类型。比如 [.] 表示 用户 空间 的 可执行程序、或者 动态链接库,而 [k] 则 表示 内核 空间。 Symbol:代表
符号 名,也 就是 函数 名。当 函数 名 未知 时,用 十六进制 的 地址 来 表示。
perf 事件类型
命令:
root@buildroot:~# perf list
功能:
查看 perf 所
打印输出
List of pre-defined events (to be used in -e or -M):

  branch-instructions OR branches                    [Hardware event]
  branch-misses                                      [Hardware event]
  bus-cycles                                         [Hardware event]
  cache-misses                                       [Hardware event]
  cache-references                                   [Hardware event]
  cpu-cycles OR cycles                               [Hardware event]
  instructions                                       [Hardware event]
  stalled-cycles-backend OR idle-cycles-backend      [Hardware event]
  stalled-cycles-frontend OR idle-cycles-frontend    [Hardware event]

  alignment-faults                                   [Software event]
  bpf-output                                         [Software event]
  cgroup-switches                                    [Software event]
  context-switches OR cs                             [Software event]
  cpu-clock                                          [Software event]
  cpu-migrations OR migrations                       [Software event]
  dummy                                              [Software event]
  emulation-faults                                   [Software event]
  major-faults                                       [Software event]
  minor-faults                                       [Software event]
  page-faults OR faults                              [Software event]
  task-clock                                         [Software event]

  duration_time                                      [Tool event]
  user_time                                          [Tool event]
  system_time                                        [Tool event]

  L1-dcache-load-misses                              [Hardware cache event]
  L1-dcache-loads                                    [Hardware cache event]
  L1-icache-load-misses                              [Hardware cache event]
  L1-icache-loads                                    [Hardware cache event]
  LLC-load-misses                                    [Hardware cache event]
  LLC-loads                                          [Hardware cache event]
  branch-load-misses                                 [Hardware cache event]
  branch-loads                                       [Hardware cache event]
  dTLB-load-misses                                   [Hardware cache event]
  dTLB-loads                                         [Hardware cache event]
  iTLB-load-misses                                   [Hardware cache event]
  iTLB-loads                                         [Hardware cache event]

  br_immed_retired OR armv8_pmuv3/br_immed_retired/  [Kernel PMU event]
  br_mis_pred OR armv8_pmuv3/br_mis_pred/            [Kernel PMU event]
  br_mis_pred_retired OR armv8_pmuv3/br_mis_pred_retired/ [Kernel PMU event]
  br_pred OR armv8_pmuv3/br_pred/                    [Kernel PMU event]
  br_retired OR armv8_pmuv3/br_retired/              [Kernel PMU event]
  br_return_retired OR armv8_pmuv3/br_return_retired/ [Kernel PMU event]
字
硬件
事件( Hardware Events) 作用:直接
使用 CPU 硬件 性能 计数器(统计 底层 硬件 行为。 关键
事件: cpu-cycles: CPU 时钟
周期 数(衡量 计算 密集型 任务)。 instructions:已
执行 指令 数(与 cycles 结合 可 计算 IPC,即 每 周期 指令 数)。 branch-misses:分支
预测 失败 次数(优化 分支 逻辑 时 关键 指标)。 cache-misses:缓存
未 命中 次数。
软件
事件( Software Events) 作用:由
内核 模拟 的 抽象 事件,不 依赖 硬件 计数器。 关键
事件: context-switches:上下文
切换 次数。 page-faults:缺页
异常 次数。 pu-migrations:进程
在 CPU 核心 间 的 迁移 次数。
硬件
缓存 事件( Hardware Cache Events) 作用:统计 CPU 缓存
层级( L1/L2/L3 )的 行为。 关键
事件: L1-dcache-load-misses: L1 数据
缓存 未 命中 次数。 LLC-load-misses:末级
缓存( L3 )未 命中 次数(若高 需 优化 内存 访问 连续性)。 iTLB-load-misses:指令 TLB 未
命中 次数。
内核 PMU 事件( Kernel PMU Events)
作用:与 CPU 架构
相关 的 硬件 事件。 关键
事件: br_mis_pred_retired:已
退休 的 错误 预测 分支 指令 数。 br_retired:已
退休 的 分支 指令 总数(计算 分支 预测 失败率)。
工具
事件( Tool Events) 作用: perf 自身
定义 的 抽象 事件,用于 统计 时间 分布。 关键
事件: duration_time:总
耗时。 user_time:用户
态 代码 耗时。 system_time:内核
态 代码 耗时。
指定
e : u // userspace
e : k // kernel
e : h // hypervisor
e : G // guest counting (in KVM guests)
e : H // host counting (not in KVM guests)
命令:
root@buildroot:~# perf top -e cycles:k
功能:
显示
打印输出:
   PerfTop:      48 irqs/sec  kernel:100.0%  exact:  0.0% lost: 0/0 drop: 0/0 [4000Hz cycles:k],  (all, 8 CPUs)
-------------------------------------------------------------------------------------------------------------------------------------------------------------

     9.72%  [kernel]       [k] format_decode
     8.56%  [kernel]       [k] number
     7.23%  [kernel]       [k] kallsyms_expand_symbol.constprop.0
     7.20%  [kernel]       [k] vsnprintf
     4.84%  [kernel]       [k] string
     4.33%  [kernel]       [k] module_get_kallsym
     2.71%  [kernel]       [k] finish_task_switch.isra.0
     2.62%  [kernel]       [k] mas_spanning_rebalance.isra.0
     2.16%  [kernel]       [k] _raw_spin_unlock_irqrestore
     1.82%  [kernel]       [k] memmove
     1.26%  [kernel]       [k] pointer
     1.23%  [kernel]       [k] mab_mas_cp
     1.17%  [kernel]       [k] update_iter
     1.09%  [kernel]       [k] strscpy
     1.09%  [kernel]       [k] __slab_free.constprop.0
     1.08%  [kernel]       [k] memset
     1.07%  [kernel]       [k] mtree_range_walk
     1.04%  [kernel]       [k] mas_descend_adopt
     0.80%  [kernel]       [k] rcu_cblist_dequeue
     0.80%  [kernel]       [k] kmem_cache_free
     0.79%  [kernel]       [k] seq_read_iter
     0.74%  [kernel]       [k] kmem_cache_alloc_bulk
     0.72%  [kernel]       [k] do_raw_spin_unlock
     0.65%  [kernel]       [k] s_next
     0.65%  [kernel]       [k] mas_wr_walk_index.isra.0
     0.62%  [kernel]       [k] __might_resched
     0.62%  [kernel]       [k] perf_iterate_sb
     0.51%  libc.so.6      [.] __mprotect
     0.50%  [kernel]       [k] perf_event_mmap
     0.46%  [kernel]       [k] kmem_cache_free_bulk.part.0
perf 统计进程信息
用于
perf stat [-e | --event=EVENT] [-a]

perf stat [-e | --event=EVENT] [-a] - []
命令:
root@buildroot:~# perf stat ls
功能:
输出
打印输出:
root@buildroot:/userdata# perf stat ls
all_in_one.signature  all_in_one.zip  gmsl  log  lost+found  perf.data  perf.txt  perf.unfold  startup.sh  tee

 Performance counter stats for 'ls':

              6.04 msec task-clock                       #    0.742 CPUs utilized
                 0      context-switches                 #    0.000 /sec
                 0      cpu-migrations                   #    0.000 /sec
               125      page-faults                      #   20.680 K/sec
           3605684      cycles                           #    0.597 GHz
           2112783      instructions                     #    0.59  insn per cycle
            250653      branches                         #   41.468 M/sec
             23909      branch-misses                    #    9.54% of all branches

       0.008141958 seconds time elapsed

       0.008350000 seconds user
       0.000000000 seconds sys
字
task-clock:
任务
真正 占用 的 处理器 时间,单位 为 ms。
context-switches:
上下文
的 切换 次数。
cpu-migrations:
处理器
迁移 次数。 Linux 为了 维持 多个 处理器 的 负载 均衡,在 特定条件 下会 将 某个 任务 从 一个 CPU 迁移 到 另 一个 CPU。
page-faults:
缺页
异常 的 次数。当 应用程序 请求 的 页面 尚未 建立、请求 的 页面 不 在 内存 中,或者 请求 的 页面 虽然 在 内存 中,但 物理地址 和 虚拟地址 的 映射 关系 尚未 建立 时,都 会 触发 一次 缺页 异常。
cycles:
消耗
的 处理器 周期 数。
instructions:
执行
了 多少 条 指令。
branches:
遇到
的 分支 指令 数。
branch-misses:
预测
错误 的 分支 指令 数。
perf stat 常用参数
-p: stat events on existing process id (comma separated list).
作用:仅
分析 目标 进程 及其 创建 的 线程。
-a: system-wide collection from all CPUs.
作用:从
所有 CPU 上 收集 性能 数据。
-r: repeat command and print average + stddev (max: 100).
作用:重复
执行命令 求 平均。
-C: Count only on the list of CPUs provided (comma separated list).
作用:从
指定 CPU 上 收集 性能 数据。
-v: be more verbose (show counter open errors, etc).
作用:显示
更 多 性能 数据。
-n: null run - don’t start any counters
作用:只
显示 任务 的 执行 时间。
-x SEP:指定
输出 列 的 分隔符。 -o file:指定
输出 文件。
命令:
root@buildroot:~# perf stat -r 10 ls > /dev/null
功能:
执行 10 次
打印输出:
 Performance counter stats for 'ls' (10 runs):

              3.21 msec task-clock                       #    0.696 CPUs utilized            ( +-  7.72% )
                 0      context-switches                 #    0.000 /sec
                 0      cpu-migrations                   #    0.000 /sec
               121      page-faults                      #   35.452 K/sec                    ( +-  0.22% )
           3842788      cycles                           #    1.126 GHz                      ( +-  1.15% )
           2038097      instructions                     #    0.54  insn per cycle           ( +-  0.35% )
            239562      branches                         #   70.189 M/sec                    ( +-  0.29% )
             22215      branch-misses                    #    9.44% of all branches          ( +-  0.41% )

          0.004613 +- 0.000344 seconds time elapsed  ( +-  7.46% )
字
在
命令:
root@buildroot:~# perf stat -v ls > /dev/null
功能:
显示
打印输出:
Using CPUID 0x00000000410fd050
Control descriptor is not initialized
task-clock: 5669250 5669250 5669250
context-switches: 0 5669250 5669250
cpu-migrations: 0 5669250 5669250
page-faults: 120 5669250 5669250
cycles: 3390596 5666583 5666583
instructions: 2003447 5666583 5666583
branches: 237261 5666583 5666583
branch-misses: 22209 5666583 5666583

 Performance counter stats for 'ls':

              5.67 msec task-clock                       #    0.732 CPUs utilized
                 0      context-switches                 #    0.000 /sec
                 0      cpu-migrations                   #    0.000 /sec
               120      page-faults                      #   21.167 K/sec
           3390596      cycles                           #    0.598 GHz
           2003447      instructions                     #    0.59  insn per cycle
            237261      branches                         #   41.851 M/sec
             22209      branch-misses                    #    9.36% of all branches

       0.007745041 seconds time elapsed

       0.007955000 seconds user
       0.000000000 seconds sys
命令:
root@buildroot:~# perf stat -n ls > /dev/null
功能:
只
打印输出:
 Performance counter stats for 'ls':

       0.003568084 seconds time elapsed

       0.003818000 seconds user
       0.000000000 seconds sys
命令:
root@buildroot:~# perf stat -a -A ls > /dev/null
功能:
单独
打印输出:
root@buildroot:~# perf stat -a -A ls > /dev/null

 Performance counter stats for 'system wide':

CPU0                     4.24 msec cpu-clock                        #    1.042 CPUs utilized
CPU1                     4.21 msec cpu-clock                        #    1.034 CPUs utilized
CPU2                     4.19 msec cpu-clock                        #    1.029 CPUs utilized
CPU3                     4.16 msec cpu-clock                        #    1.024 CPUs utilized
CPU4                     4.15 msec cpu-clock                        #    1.020 CPUs utilized
CPU5                     4.14 msec cpu-clock                        #    1.017 CPUs utilized
CPU6                     4.13 msec cpu-clock                        #    1.016 CPUs utilized
CPU7                     4.11 msec cpu-clock                        #    1.010 CPUs utilized
CPU0                        3      context-switches                 #  708.159 /sec
CPU1                        3      context-switches                 #  713.225 /sec
CPU2                        3      context-switches                 #  716.625 /sec
CPU3                        3      context-switches                 #  720.295 /sec
CPU4                        3      context-switches                 #  723.117 /sec
CPU5                        5      context-switches                 #    1.208 K/sec
CPU6                        3      context-switches                 #  726.194 /sec
CPU7                        5      context-switches                 #    1.217 K/sec
CPU0                        1      cpu-migrations                   #  236.053 /sec
CPU1                        1      cpu-migrations                   #  237.742 /sec
CPU2                        1      cpu-migrations                   #  238.875 /sec
CPU3                        1      cpu-migrations                   #  240.098 /sec
CPU4                        1      cpu-migrations                   #  241.039 /sec
CPU5                        1      cpu-migrations                   #  241.687 /sec
CPU6                        1      cpu-migrations                   #  242.065 /sec
CPU7                        1      cpu-migrations                   #  243.408 /sec
perf record 收集信息
收集
常用
perf record 可用perf record -h 查看。
-a:分析
整个 系统 的 性能 -A:以 append 的
方式 写 输出 文件 -c:事件
的 采样 周期 -C:只
采集 指定 CPU 数据 -e:选择
性能 事件,可以 是 硬件 事件 也 可以 是 软件 事件 -f:以 OverWrite 的
方式 写 输出 文件 -g:记录
函数 间 的 调用 关系 -o:指定
输出 文件,默认 为 perf.data -p:指定
一个 进程 的 ID 来 采集 特定 进程 的 数据 -t:指定
一个 线程 的 ID 来 采集 特定 线程 的 数据
命令:
root@buildroot:~# perf record -a -F 1000 sleep 5
功能:
用 1000 统计
命令:
root@buildroot:~# perf record -p xxx -g
功能:
监控 PID=xxx 的
root@buildroot:~# perf record -p xxx -g -o pidxxx.data
功能:
监控 PID=xxx 的
perf report 分析结果
perf report 对 perf record 生成
常用
perf report 可用perf report -h 查看。
-c:指定
采样 周期 -C:只
显示 指定 CPU 的 信息 -d:只
显示 指定 dos 的 符号 -g:生成
函数调用 关系 图,具体 等同于 perf top 命令 中 的 -g -i:导入
的 数据文件 的 名称,默认 为 perf.data -M:以
指定 汇编 指令 风格 显示 –sort:分类
统计 信息,如 PID、 COMM、 CPU 等 -S:只
考虑 指定 符号 -U:只
显示 已 解析 的 符号 -v:显示
每个 符号 的 地址
命令:
root@buildroot:~# perf report -i perf.data
功能:
对 perf record 生成
打印输出:
# To display the perf.data header info, please use --header/--header-only options.
#
#
# Total Lost Samples: 0
#
# Samples: 505  of event 'cycles'
# Event count (approx.): 16387804
#
# Children      Self  Command          Shared Object      Symbol
# ........  ........  ...............  .................  ........................................
  [[31m  72.50%[[m     0.00%  swapper          [kernel.kallsyms]  [k] cpu_startup_entry
            |
            ---cpu_startup_entry
               |
                --[[31m71.81%[[m--do_idle
                          |
                          |--[[31m46.64%[[m--default_idle_call
                          |          |
                          |           --[[31m46.21%[[m--arch_cpu_idle
                          |                     |
                          |                      --[[31m14.86%[[m--el1h_64_irq
                          |                                el1h_64_irq_handler
                          |                                el1_interrupt
                          |                                irq_exit_rcu
                          |                                __irq_exit_rcu
                          |                                do_softirq_own_stack
                          |                                call_on_irq_stack
                          |                                ____do_softirq
                          |                                __softirqentry_text_start
                          |                                |
                          |                                |--[[31m6.68%[[m--run_timer_softirq
                          |                                |          |
                          |                                |           --[[31m6.34%[[m--__run_timers.part.0
                          |                                |                     |
                          |                                |                     |--[[32m3.45%[[m--call_timer_fn.constprop.0
                          |                                |                     |          |
                          |                                |                     |          |--[[32m1.72%[[m--process_timeout
                          |                                |                     |          |          wake_up_process
                          |                                |                     |          |          try_to_wake_up
                          |                                |                     |          |          _raw_spin_unlock_irqrestore
                          |                                |                     |          |
                          |                                |                     |           --[[32m0.86%[[m--tcp_orphan_update
                          |                                |                     |
                          |                                |                      --[[32m2.89%[[m--_raw_spin_unlock_irq
                          |                                |
                          |                                |--[[32m4.39%[[m--run_rebalance_domains
                          |                                |          |
                          |                                |          |--[[32m2.50%[[m--rebalance_domains
                          |                                |          |          |
                          |                                |          |           --[[32m2.10%[[m--load_balance
                          |                                |          |                     |
                          |                                |          |                      --[[32m0.75%[[m--find_busiest_group
                          |                                |          |
                          |                                |           --[[32m1.89%[[m--update_blocked_averages
                          |                                |
                          |                                 --[[32m1.59%[[m--rcu_core_si
                          |                                           |
                          |                                           |--[[32m0.90%[[m--file_free_rcu
                          |                                           |
                          |                                            --[[32m0.57%[[m--rcu_core
                          |
                          |--[[31m10.88%[[m--schedule_idle
                          |          __schedule
                          |          finish_task_switch.isra.0
                          |
                          |--[[31m8.46%[[m--nohz_run_idle_balance
                          |          |
                          |          |--[[31m7.71%[[m--_nohz_idle_balance.isra.0
                          |          |          |
                          |          |           --[[32m3.49%[[m--update_blocked_averages
                          |          |
                          |           --[[32m0.52%[[m--_find_next_bit
                          |
                           --[[32m4.75%[[m--tick_nohz_idle_exit
perf 生成火焰图
步骤一
在 xbuild 编译系统
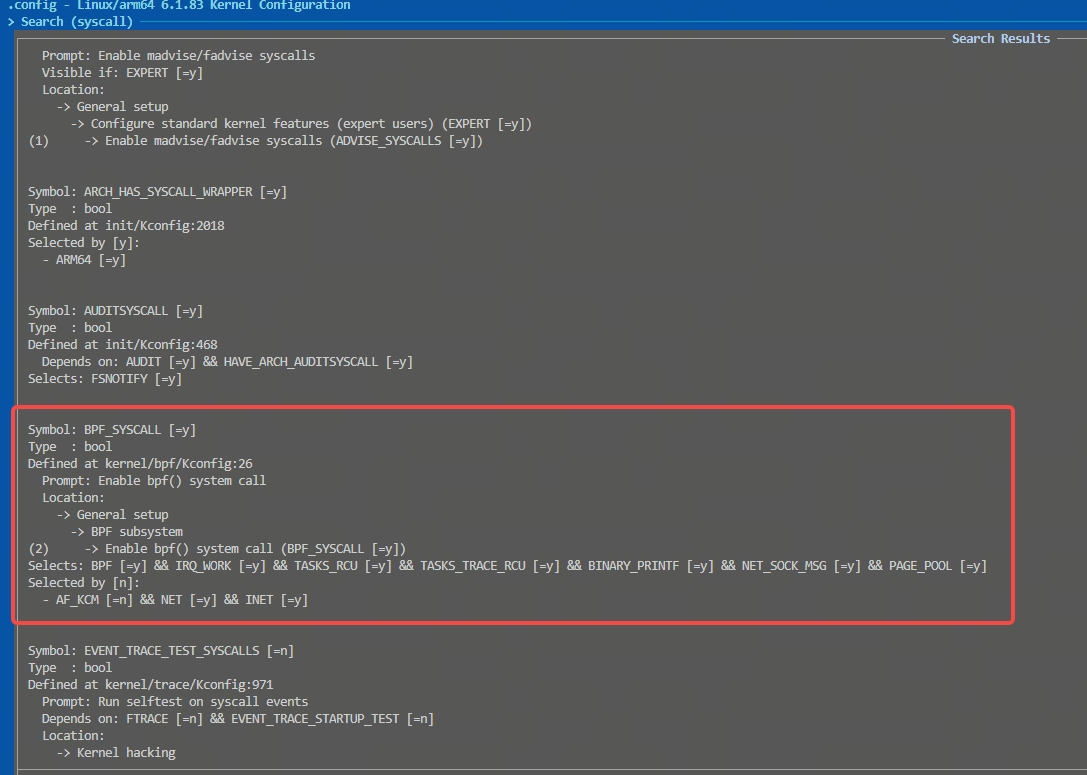
./bd.sh boot menuconfig
需要BPF_SYSCALL 进行
步骤二
使用 perf script 工具
perf script -i perf.data &> perf.unfold
步骤三
火焰
git clone https://github.com/brendangregg/FlameGraph.git
下载
├── README.md
├── aix-perf.pl
├── demos
│   ├── README
│   ├── brkbytes-mysql.svg
│   ├── cpu-grep.svg
│   ├── cpu-illumos-ipdce.svg
│   ├── cpu-illumos-syscalls.svg
│   ├── cpu-illumos-tcpfuse.svg
│   ├── cpu-iozone.svg
│   ├── cpu-ipnet-diff.svg
│   ├── cpu-linux-tar.svg
│   ├── cpu-linux-tcpsend.svg
│   ├── cpu-mixedmode-flamegraph-java.svg
│   ├── cpu-mysql-filt.svg
│   ├── cpu-mysql.svg
│   ├── cpu-qemu-both.svg
│   ├── cpu-zoomable.html
│   ├── hotcold-kernelthread.svg
│   ├── io-gzip.svg
│   ├── io-mysql.svg
│   ├── mallocbytes-bash.svg
│   ├── off-bash.svg
│   ├── off-mysql-busy.svg
│   ├── off-mysql-idle.svg
│   ├── palette-example-broken.svg
│   └── palette-example-working.svg
├── dev
│   ├── README
│   ├── gatherhc-kern.d
│   ├── gatherthc-kern.d
│   ├── hcstackcollapse.pl
│   ├── hotcoldgraph.pl
│   └── thcstackcollapse.pl
├── difffolded.pl
├── docs
│   └── cddl1.txt
├── example-dtrace-stacks.txt
├── example-dtrace.svg
├── example-perf-stacks.txt.gz
├── example-perf.svg
├── files.pl
├── flamegraph.pl
├── jmaps
├── perf.folded
├── perf.svg
├── perf.unfold
├── pkgsplit-perf.pl
├── range-perf.pl
├── record-test.sh
├── stackcollapse-aix.pl
├── stackcollapse-bpftrace.pl
├── stackcollapse-chrome-tracing.py
├── stackcollapse-elfutils.pl
├── stackcollapse-faulthandler.pl
├── stackcollapse-gdb.pl
├── stackcollapse-go.pl
├── stackcollapse-ibmjava.pl
├── stackcollapse-instruments.pl
├── stackcollapse-java-exceptions.pl
├── stackcollapse-jstack.pl
├── stackcollapse-ljp.awk
├── stackcollapse-perf-sched.awk
├── stackcollapse-perf.pl
├── stackcollapse-pmc.pl
├── stackcollapse-recursive.pl
├── stackcollapse-sample.awk
├── stackcollapse-stap.pl
├── stackcollapse-vsprof.pl
├── stackcollapse-vtune-mc.pl
├── stackcollapse-vtune.pl
├── stackcollapse-wcp.pl
├── stackcollapse-xdebug.php
├── stackcollapse.pl
├── test
│   ├── perf-cycles-instructions-01.txt
│   ├── perf-dd-stacks-01.txt
│   ├── perf-funcab-cmd-01.txt
│   ├── perf-funcab-pid-01.txt
│   ├── perf-iperf-stacks-pidtid-01.txt
│   ├── perf-java-faults-01.txt
│   ├── perf-java-stacks-01.txt
│   ├── perf-java-stacks-02.txt
│   ├── perf-js-stacks-01.txt
│   ├── perf-mirageos-stacks-01.txt
│   ├── perf-numa-stacks-01.txt
│   ├── perf-rust-Yamakaky-dcpu.txt
│   ├── perf-vertx-stacks-01.txt
│   └── results
│       ├── perf-cycles-instructions-01-collapsed-addrs.txt
│       ├── perf-cycles-instructions-01-collapsed-all.txt
│       ├── perf-cycles-instructions-01-collapsed-jit.txt
│       ├── perf-cycles-instructions-01-collapsed-kernel.txt
│       ├── perf-cycles-instructions-01-collapsed-pid.txt
│       ├── perf-cycles-instructions-01-collapsed-tid.txt
│       ├── perf-dd-stacks-01-collapsed-addrs.txt
│       ├── perf-dd-stacks-01-collapsed-all.txt
│       ├── perf-dd-stacks-01-collapsed-jit.txt
│       ├── perf-dd-stacks-01-collapsed-kernel.txt
│       ├── perf-dd-stacks-01-collapsed-pid.txt
│       ├── perf-dd-stacks-01-collapsed-tid.txt
│       ├── perf-funcab-cmd-01-collapsed-addrs.txt
│       ├── perf-funcab-cmd-01-collapsed-all.txt
│       ├── perf-funcab-cmd-01-collapsed-jit.txt
│       ├── perf-funcab-cmd-01-collapsed-kernel.txt
│       ├── perf-funcab-cmd-01-collapsed-pid.txt
│       ├── perf-funcab-cmd-01-collapsed-tid.txt
│       ├── perf-funcab-pid-01-collapsed-addrs.txt
│       ├── perf-funcab-pid-01-collapsed-all.txt
│       ├── perf-funcab-pid-01-collapsed-jit.txt
│       ├── perf-funcab-pid-01-collapsed-kernel.txt
│       ├── perf-funcab-pid-01-collapsed-pid.txt
│       ├── perf-funcab-pid-01-collapsed-tid.txt
│       ├── perf-iperf-stacks-pidtid-01-collapsed-addrs.txt
│       ├── perf-iperf-stacks-pidtid-01-collapsed-all.txt
│       ├── perf-iperf-stacks-pidtid-01-collapsed-jit.txt
│       ├── perf-iperf-stacks-pidtid-01-collapsed-kernel.txt
│       ├── perf-iperf-stacks-pidtid-01-collapsed-pid.txt
│       ├── perf-iperf-stacks-pidtid-01-collapsed-tid.txt
│       ├── perf-java-faults-01-collapsed-addrs.txt
│       ├── perf-java-faults-01-collapsed-all.txt
│       ├── perf-java-faults-01-collapsed-jit.txt
│       ├── perf-java-faults-01-collapsed-kernel.txt
│       ├── perf-java-faults-01-collapsed-pid.txt
│       ├── perf-java-faults-01-collapsed-tid.txt
│       ├── perf-java-stacks-01-collapsed-addrs.txt
│       ├── perf-java-stacks-01-collapsed-all.txt
│       ├── perf-java-stacks-01-collapsed-jit.txt
│       ├── perf-java-stacks-01-collapsed-kernel.txt
│       ├── perf-java-stacks-01-collapsed-pid.txt
│       ├── perf-java-stacks-01-collapsed-tid.txt
│       ├── perf-java-stacks-02-collapsed-addrs.txt
│       ├── perf-java-stacks-02-collapsed-all.txt
│       ├── perf-java-stacks-02-collapsed-jit.txt
│       ├── perf-java-stacks-02-collapsed-kernel.txt
│       ├── perf-java-stacks-02-collapsed-pid.txt
│       ├── perf-java-stacks-02-collapsed-tid.txt
│       ├── perf-js-stacks-01-collapsed-addrs.txt
│       ├── perf-js-stacks-01-collapsed-all.txt
│       ├── perf-js-stacks-01-collapsed-jit.txt
│       ├── perf-js-stacks-01-collapsed-kernel.txt
│       ├── perf-js-stacks-01-collapsed-pid.txt
│       ├── perf-js-stacks-01-collapsed-tid.txt
│       ├── perf-mirageos-stacks-01-collapsed-addrs.txt
│       ├── perf-mirageos-stacks-01-collapsed-all.txt
│       ├── perf-mirageos-stacks-01-collapsed-jit.txt
│       ├── perf-mirageos-stacks-01-collapsed-kernel.txt
│       ├── perf-mirageos-stacks-01-collapsed-pid.txt
│       ├── perf-mirageos-stacks-01-collapsed-tid.txt
│       ├── perf-numa-stacks-01-collapsed-addrs.txt
│       ├── perf-numa-stacks-01-collapsed-all.txt
│       ├── perf-numa-stacks-01-collapsed-jit.txt
│       ├── perf-numa-stacks-01-collapsed-kernel.txt
│       ├── perf-numa-stacks-01-collapsed-pid.txt
│       ├── perf-numa-stacks-01-collapsed-tid.txt
│       ├── perf-rust-Yamakaky-dcpu-collapsed-addrs.txt
│       ├── perf-rust-Yamakaky-dcpu-collapsed-all.txt
│       ├── perf-rust-Yamakaky-dcpu-collapsed-jit.txt
│       ├── perf-rust-Yamakaky-dcpu-collapsed-kernel.txt
│       ├── perf-rust-Yamakaky-dcpu-collapsed-pid.txt
│       ├── perf-rust-Yamakaky-dcpu-collapsed-tid.txt
│       ├── perf-vertx-stacks-01-collapsed-addrs.txt
│       ├── perf-vertx-stacks-01-collapsed-all.txt
│       ├── perf-vertx-stacks-01-collapsed-jit.txt
│       ├── perf-vertx-stacks-01-collapsed-kernel.txt
│       ├── perf-vertx-stacks-01-collapsed-pid.txt
│       └── perf-vertx-stacks-01-collapsed-tid.txt
└── test.sh
可perf.unfold 文件FlameGraph 目录stackcollapse-perf.pl 工具
./stackcollapse-perf.pl perf.unfold &> perf.folded
步骤四
使用 flamegraph.pl 工具
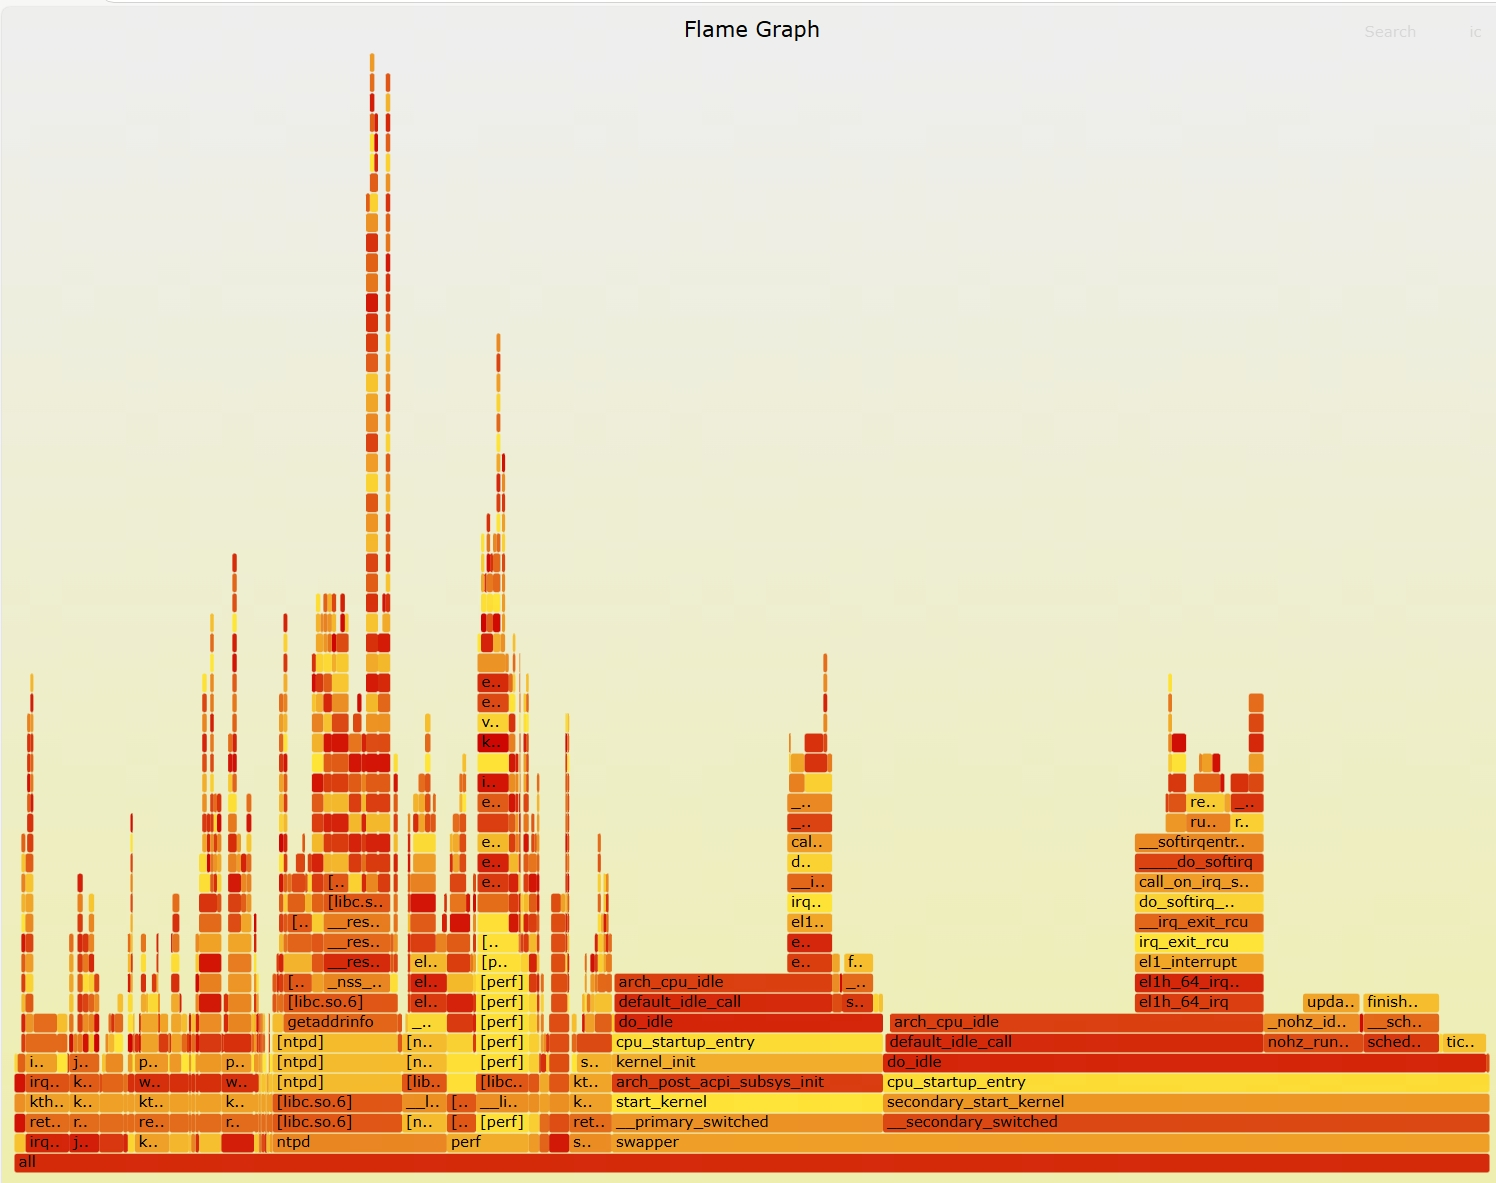
./flamegraph.pl perf.folded > perf.svg
可以
火焰图解析
火焰图核心结构
横轴( X 轴)
- 表示 CPU 时间分布,宽度越大的区块代表该函数或代码路径消耗的 CPU 时间比例越高,可能是性能瓶颈点。
- 同一层级的所有调用栈并行排列,不表示时间顺序。
纵轴( Y 轴)
- 表示 调用栈深度,从下到上展示函数调用关系。
- 底层是程序入口(如 main 函数),上层是当前正在执行的函数。
颜色与区块
- 颜色通常仅用于区分不同函数,无固定含义。
- 高且宽的“平顶”火焰(同一函数多次出现在调用栈顶部)是性能优化的关键目标。
火焰图分析步骤
定位 CPU 热点
- 打开 SVG 火焰图,横向观察最宽的区块,快速识别消耗 CPU 时间最多的函数。
分析调用链
- 从底层到顶层逐层查看调用关系,确定热点函数的调用路径。
结合 iperf 工作模式
- 服务端火焰图:关注 accept、 recv 等接收逻辑的 CPU 开销。
- 客户端火焰图:聚焦 connect、 send 等发送逻辑的性能损耗。