6.4.2. 快速上手
Horizon Plugin Pytorch (下称 Plugin ) 参考
6.4.2.1. 基本流程
量化
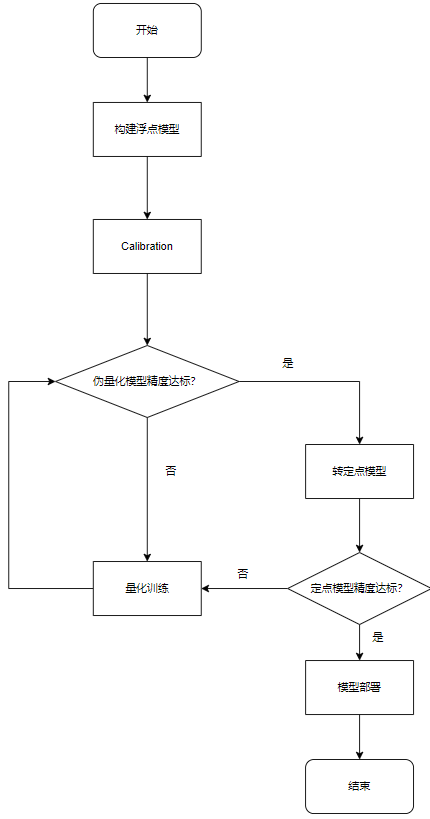
下面torchvision 中MobileNetV2 模型
出于cifar-10 数据
import os
import copy
import numpy as np
import torch
import torch.nn as nn
import torchvision.transforms as transforms
from torch import Tensor
from torch.quantization import DeQuantStub
from torchvision.datasets import CIFAR10
from torchvision.models.mobilenetv2 import MobileNetV2
from torch.utils import data
from typing import Optional, Callable, List, Tuple

from horizon_plugin_pytorch.functional import rgb2centered_yuv

import torch.quantization
from horizon_plugin_pytorch.march import March, set_march
from horizon_plugin_pytorch.quantization import (
    QuantStub,
    convert_fx,
    prepare_qat_fx,
    set_fake_quantize,
    FakeQuantState,
    check_model,
    compile_model,
    perf_model,
    visualize_model,
)
from horizon_plugin_pytorch.quantization.qconfig import (
    default_calib_8bit_fake_quant_qconfig,
    default_qat_8bit_fake_quant_qconfig,
    default_qat_8bit_weight_32bit_out_fake_quant_qconfig,
    default_calib_8bit_weight_32bit_out_fake_quant_qconfig,
)

import logging
logging.basicConfig(level=logging.INFO, format="%(levelname)s: %(message)s")
class AverageMeter(object):
    """Computes and stores the average and current value"""

    def __init__(self, name: str, fmt=":f"):
        self.name = name
        self.fmt = fmt
        self.reset()

    def reset(self):
        self.val = 0
        self.avg = 0
        self.sum = 0
        self.count = 0

    def update(self, val, n=1):
        self.val = val
        self.sum += val * n
        self.count += n
        self.avg = self.sum / self.count

    def __str__(self):
        fmtstr = "{name} {val" + self.fmt + "} ({avg" + self.fmt + "})"
        return fmtstr.format(**self.__dict__)


    def accuracy(output: Tensor, target: Tensor, topk=(1,)) -> List[Tensor]:
        """Computes the accuracy over the k top predictions for the specified
        values of k
        """
        with torch.no_grad():
            maxk = max(topk)
            batch_size = target.size(0)

            _, pred = output.topk(maxk, 1, True, True)
            pred = pred.t()
            correct = pred.eq(target.view(1, -1).expand_as(pred))

            res = []
            for k in topk:
                correct_k = correct[:k].float().sum()
                res.append(correct_k.mul_(100.0 / batch_size))
            return res


    def evaluate(
        model: nn.Module, data_loader: data.DataLoader, device: torch.device
    ) -> Tuple[AverageMeter, AverageMeter]:
        top1 = AverageMeter("Acc@1", ":6.2f")
        top5 = AverageMeter("Acc@5", ":6.2f")

        with torch.no_grad():
            for image, target in data_loader:
                image, target = image.to(device), target.to(device)
                output = model(image)
                output = output.view(-1, 10)
                acc1, acc5 = accuracy(output, target, topk=(1, 5))
                top1.update(acc1, image.size(0))
                top5.update(acc5, image.size(0))
                print(".", end="", flush=True)
            print()

        return top1, top5


    def train_one_epoch(
        model: nn.Module,
        criterion: Callable,
        optimizer: torch.optim.Optimizer,
        scheduler: Optional[torch.optim.lr_scheduler._LRScheduler],
        data_loader: data.DataLoader,
        device: torch.device,
    ) -> None:
        top1 = AverageMeter("Acc@1", ":6.3f")
        top5 = AverageMeter("Acc@5", ":6.3f")
        avgloss = AverageMeter("Loss", ":1.5f")

        model.to(device)

        for image, target in data_loader:
            image, target = image.to(device), target.to(device)
            output = model(image)
            output = output.view(-1, 10)
            loss = criterion(output, target)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            if scheduler is not None:
                scheduler.step()
            acc1, acc5 = accuracy(output, target, topk=(1, 5))
            top1.update(acc1, image.size(0))
            top5.update(acc5, image.size(0))
            avgloss.update(loss, image.size(0))
            print(".", end="", flush=True)
        print()

        print(
            "Full cifar-10 train set: Loss {:.3f} Acc@1"
            " {:.3f} Acc@5 {:.3f}".format(avgloss.avg, top1.avg, top5.avg)
        )
6.4.2.2. 获取浮点模型
首先,对
在
模型 输入 前 插入 QuantStub在
模型 输出 后 插入 DequantStub
改造
插入
的 QuantStub和DequantStub必须注册 为 模型 的 子 模块,否则 将 无法 正确处理 它们 的 量化 状态 多个
输入 仅 在 scale相同时 可以 共享 QuantStub,否则请为 每个 输入 定义 单独 的 QuantStub若
需要 将 上 板 时 输入 的 数据 来源 指定 为 "pyramid",请手动 设置 对应 QuantStub的scale参数为 1/128 也
可以 使用 torch.quantization.QuantStub,但是仅 有 horizon_plugin_pytorch.quantization.QuantStub支持通过 参数 手动 固定 scale
改造
注意:
模型rgb2centered_yuv 的
######################################################################
# 用户可根据需要修改以下参数
# 1. 模型 ckpt 和编译产出物的保存路径
model_path = "model/mobilenetv2"
# 2. 数据集下载和保存的路径
data_path = "data"
# 3. 训练时使用的 batch_size
train_batch_size = 256
# 4. 预测时使用的 batch_size
eval_batch_size = 256
# 5. 训练的 epoch 数
epoch_num = 30
# 6. 模型保存和执行计算使用的 device
device = (
    torch.device("cuda") if torch.cuda.is_available() else torch.device("cpu")
)
######################################################################


# 准备数据集,请注意 collate_fn 中对 rgb2centered_yuv 的使用
def prepare_data_loaders(
    data_path: str, train_batch_size: int, eval_batch_size: int
) -> Tuple[data.DataLoader, data.DataLoader]:
    normalize = transforms.Normalize(mean=0.0, std=128.0)

    def collate_fn(batch):
        batched_img = torch.stack(
            [
                torch.from_numpy(np.array(example[0], np.uint8, copy=True))
                for example in batch
            ]
        ).permute(0, 3, 1, 2)
        batched_target = torch.tensor([example[1] for example in batch])

        batched_img = rgb2centered_yuv(batched_img)
        batched_img = normalize(batched_img.float())

        return batched_img, batched_target

    train_dataset = CIFAR10(
        data_path,
        True,
        transforms.Compose(
            [
                transforms.RandomHorizontalFlip(),
                transforms.RandAugment(),
            ]
        ),
        download=True,
    )

    eval_dataset = CIFAR10(
        data_path,
        False,
        download=True,
    )

    train_data_loader = data.DataLoader(
        train_dataset,
        batch_size=train_batch_size,
        sampler=data.RandomSampler(train_dataset),
        num_workers=8,
        collate_fn=collate_fn,
        pin_memory=True,
    )

    eval_data_loader = data.DataLoader(
        eval_dataset,
        batch_size=eval_batch_size,
        sampler=data.SequentialSampler(eval_dataset),
        num_workers=8,
        collate_fn=collate_fn,
        pin_memory=True,
    )

    return train_data_loader, eval_data_loader


# 对浮点模型做必要的改造
class FxQATReadyMobileNetV2(MobileNetV2):
    def __init__(
        self,
        num_classes: int = 10,
        width_mult: float = 1.0,
        inverted_residual_setting: Optional[List[List[int]]] = None,
        round_nearest: int = 8,
    ):
        super().__init__(
            num_classes, width_mult, inverted_residual_setting, round_nearest
        )
        self.quant = QuantStub(scale=1 / 128)
        self.dequant = DeQuantStub()

    def forward(self, x: Tensor) -> Tensor:
        x = self.quant(x)
        x = super().forward(x)
        x = self.dequant(x)

        return x


if not os.path.exists(model_path):
    os.makedirs(model_path, exist_ok=True)

# 浮点模型初始化
float_model = FxQATReadyMobileNetV2()

# 准备数据集
train_data_loader, eval_data_loader = prepare_data_loaders(
    data_path, train_batch_size, eval_batch_size
)

# 由于模型的最后一层和预训练模型不一致,需要进行浮点 finetune
optimizer = torch.optim.Adam(
    float_model.parameters(), lr=0.001, weight_decay=1e-3
)
best_acc = 0

for nepoch in range(epoch_num):
    float_model.train()
    train_one_epoch(
        float_model,
        nn.CrossEntropyLoss(),
        optimizer,
        None,
        train_data_loader,
        device,
    )

    # 浮点精度测试
    float_model.eval()
    top1, top5 = evaluate(float_model, eval_data_loader, device)

    print(
        "Float Epoch {}: evaluation Acc@1 {:.3f} Acc@5 {:.3f}".format(
            nepoch, top1.avg, top5.avg
        )
    )

    if top1.avg > best_acc:
        best_acc = top1.avg
        # 保存最佳浮点模型参数
        torch.save(
            float_model.state_dict(),
            os.path.join(model_path, "float-checkpoint.ckpt"),
        )
Files already downloaded and verified
Files already downloaded and verified
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 2.158 Acc@1 19.574 Acc@5 68.712
........................................
Float Epoch 0: evaluation Acc@1 30.270 Acc@5 84.650
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 1.855 Acc@1 31.136 Acc@5 82.658
........................................
Float Epoch 1: evaluation Acc@1 40.310 Acc@5 89.640
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 1.693 Acc@1 37.250 Acc@5 87.292
........................................
Float Epoch 2: evaluation Acc@1 46.500 Acc@5 92.000
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 1.596 Acc@1 41.956 Acc@5 89.068
........................................
Float Epoch 3: evaluation Acc@1 48.400 Acc@5 92.650
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 1.520 Acc@1 44.974 Acc@5 90.322
........................................
Float Epoch 4: evaluation Acc@1 52.620 Acc@5 93.360
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 1.441 Acc@1 48.216 Acc@5 91.434
........................................
...
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 0.722 Acc@1 75.058 Acc@5 98.132
........................................
Float Epoch 29: evaluation Acc@1 75.940 Acc@5 98.030
6.4.2.3. Calibration
模型
对于
部分 模型,仅 通过 Calibration 便 可 使 精度 达到 要求,不必 进行 比较 耗时 的 量化 感知 训练。 即使
模型 经过 量化 校准 后 无法 满足 精度 要求,此 过程 也 可 降低 后续 量化 感知 训练 的 难度,缩短 训练 时间,提升 最终 的 训练 精度。
######################################################################
# 用户可根据需要修改以下参数
# 1. Calibration 时使用的 batch_size
calib_batch_size = 256
# 2. Validation 时使用的 batch_size
eval_batch_size = 256
# 3. Calibration 使用的数据量,配置为 inf 以使用全部数据
num_examples = float("inf")
# 4. 目标硬件平台的代号,此处使用 bayes 举例,实际使用时需要根据实际部署平台做相应替换
march = March.BAYES
######################################################################

# 在进行模型转化前,必须设置好模型将要执行的硬件平台
set_march(march)


# 将模型转化为 Calibration 状态,以统计各处数据的数值分布特征
calib_model = prepare_qat_fx(
    # 输出模型会共享输入模型的 attributes,为不影响 float_model 的后续使用,
    # 此处进行了 deepcopy
    copy.deepcopy(float_model),
    {
        "": default_calib_8bit_fake_quant_qconfig,
        "module_name": {
            # 在模型的输出层为 Conv 或 Linear 时,可以使用 out_qconfig
            # 配置为高精度输出
            "classifier": default_calib_8bit_weight_32bit_out_fake_quant_qconfig,
        },
    },
).to(
    device
)  # prepare_qat_fx 接口不保证输出模型的 device 和输入模型完全一致

# 准备数据集
calib_data_loader, eval_data_loader = prepare_data_loaders(
    data_path, calib_batch_size, eval_batch_size
)

# 执行 Calibration 过程(不需要 backward)
# 注意此处对模型状态的控制,模型需要处于 eval 状态以使 Bn 的行为符合要求
calib_model.eval()
set_fake_quantize(calib_model, FakeQuantState.CALIBRATION)
with torch.no_grad():
    cnt = 0
    for image, target in calib_data_loader:
        image, target = image.to(device), target.to(device)
        calib_model(image)
        print(".", end="", flush=True)
        cnt += image.size(0)
        if cnt >= num_examples:
            break
    print()

# 测试伪量化精度
# 注意此处对模型状态的控制
calib_model.eval()
set_fake_quantize(calib_model, FakeQuantState.VALIDATION)

top1, top5 = evaluate(
    calib_model,
    eval_data_loader,
    device,
)
print(
    "Calibration: evaluation Acc@1 {:.3f} Acc@5 {:.3f}".format(
        top1.avg, top5.avg
    )
)

# 保存 Calibration 模型参数
torch.save(
    calib_model.state_dict(),
    os.path.join(model_path, "calib-checkpoint.ckpt"),
)
Files already downloaded and verified
Files already downloaded and verified
....................................................................................................................................................................................................
........................................
Calibration: evaluation Acc@1 76.190 Acc@5 98.180
模型
6.4.2.4. 量化感知训练
量化
######################################################################
# 用户可根据需要修改以下参数
# 1. 训练时使用的 batch_size
train_batch_size = 256
# 2. Validation 时使用的 batch_size
eval_batch_size = 256
# 3. 训练的 epoch 数
epoch_num = 3
######################################################################

# 准备数据集
train_data_loader, eval_data_loader = prepare_data_loaders(
    data_path, train_batch_size, eval_batch_size
)

# 将模型转为 QAT 状态
qat_model = prepare_qat_fx(
    copy.deepcopy(float_model),
    {
        "": default_qat_8bit_fake_quant_qconfig,
        "module_name": {
            "classifier": default_qat_8bit_weight_32bit_out_fake_quant_qconfig,
        },
    },
).to(device)

# 加载 Calibration 模型中的量化参数
qat_model.load_state_dict(calib_model.state_dict())

# 进行量化感知训练
# 作为一个 filetune 过程,量化感知训练一般需要设定较小的学习率
optimizer = torch.optim.Adam(
    qat_model.parameters(), lr=1e-3, weight_decay=1e-4
)

best_acc = 0

for nepoch in range(epoch_num):
    # 注意此处对 QAT 模型 training 状态的控制方法
    qat_model.train()
    set_fake_quantize(qat_model, FakeQuantState.QAT)

    train_one_epoch(
        qat_model,
        nn.CrossEntropyLoss(),
        optimizer,
        None,
        train_data_loader,
        device,
    )

    # 注意此处对 QAT 模型 eval 状态的控制方法
    qat_model.eval()
    set_fake_quantize(qat_model, FakeQuantState.VALIDATION)

    top1, top5 = evaluate(
        qat_model,
        eval_data_loader,
        device,
    )
    print(
        "QAT Epoch {}: evaluation Acc@1 {:.3f} Acc@5 {:.3f}".format(
            nepoch, top1.avg, top5.avg
        )
    )

    if top1.avg > best_acc:
        best_acc = top1.avg

        torch.save(
            qat_model.state_dict(),
            os.path.join(model_path, "qat-checkpoint.ckpt"),
        )
Files already downloaded and verified
Files already downloaded and verified
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 0.770 Acc@1 73.462 Acc@5 97.816
........................................
QAT Epoch 0: evaluation Acc@1 77.620 Acc@5 98.310
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 0.737 Acc@1 74.494 Acc@5 98.016
........................................
QAT Epoch 1: evaluation Acc@1 76.590 Acc@5 98.370
....................................................................................................................................................................................................
Full cifar-10 train set: Loss 0.732 Acc@1 74.830 Acc@5 98.066
........................................
QAT Epoch 2: evaluation Acc@1 77.950 Acc@5 98.480
6.4.2.5. 转定点模型
伪
注意:
定点
######################################################################
# 用户可根据需要修改以下参数
# 1. 使用哪个模型作为流程的输入,可以选择 calib_model 或 qat_model
base_model = qat_model
######################################################################

# 将模型转为定点状态
quantized_model = convert_fx(base_model).to(device)

# 测试定点模型精度
top1, top5 = evaluate(
    quantized_model,
    eval_data_loader,
    device,
)
print(
    "Quantized model: evaluation Acc@1 {:.3f} Acc@5 {:.3f}".format(
        top1.avg, top5.avg
    )
)
........................................
Quantized model: evaluation Acc@1 78.000 Acc@5 98.480
6.4.2.6. 模型部署
测试
注意:
也
可以 跳过 Calibration 和 量化 感知 训练 中 的 实际 校准 和 训练 过程,先 直接 进行 模型 检查,以 保证 模型 中 不 存在 无法 编译 的 操作。 由于
编译器 只 支持 CPU,因此 模型 和 数据 必须 放在 CPU 上。
######################################################################
# 用户可根据需要修改以下参数
# 1. 编译时启用的优化等级,可选 0~3,等级越高编译出的模型上板执行速度越快,
#    但编译过程会慢
compile_opt = "O1"
######################################################################

# 这里的 example_input 也可以是随机生成的数据,但是推荐使用真实数据,以提高
# 性能测试的准确性
example_input = next(iter(eval_data_loader))[0]

# 通过 trace 将模型序列化并生成计算图,注意模型和数据要放在 CPU 上
script_model = torch.jit.trace(quantized_model.cpu(), example_input)
torch.jit.save(script_model, os.path.join(model_path, "int_model.pt"))

# 模型检查
check_model(script_model, [example_input])
torch.Size([1, 3, 32, 32])
/home/users/horizon/qat_docs/horizon_plugin_pytorch/qtensor.py:1178: TracerWarning: Converting a tensor to a Python boolean might cause the trace to be incorrect. We can't record the data flow of Python values, so this value will be treated as a constant in the future. This means that the trace might not generalize to other inputs!
if scale is not None and scale.numel() > 1:
/home/users/horizon/qat_docs/horizon_plugin_pytorch/nn/quantized/conv2d.py:290: TracerWarning: Converting a tensor to a Python boolean might cause the trace to be incorrect. We can't record the data flow of Python values, so this value will be treated as a constant in the future. This means that the trace might not generalize to other inputs!
per_channel_axis=-1 if self.out_scale.numel() == 1 else 1,
This model is supported!
HBDK model check PASS
# 模型编译,生成的 hbm 文件即为可部署的模型
compile_model(
    script_model,
    [example_input],
    hbm=os.path.join(model_path, "model.hbm"),
    input_source="pyramid",
    opt=compile_opt,
)
INFO: launch 16 threads for optimization
[==================================================] 100%
WARNING: arg0 can not be assigned to NCHW_NATIVE layout because it's input source is pyramid/resizer.
consumed time 0.655841
HBDK model compilation SUCCESS
# 模型性能测试
perf_model(
    script_model,
    [example_input],
    out_dir=os.path.join(model_path, "perf_out"),
    input_source="pyramid",
    opt=compile_opt,
    layer_details=True,
)
INFO: launch 16 threads for optimization
[==================================================] 100%
WARNING: arg0 can not be assigned to NCHW_NATIVE layout because it's input source is pyramid/resizer.
consumed time 0.587685
HBDK model compilation SUCCESS
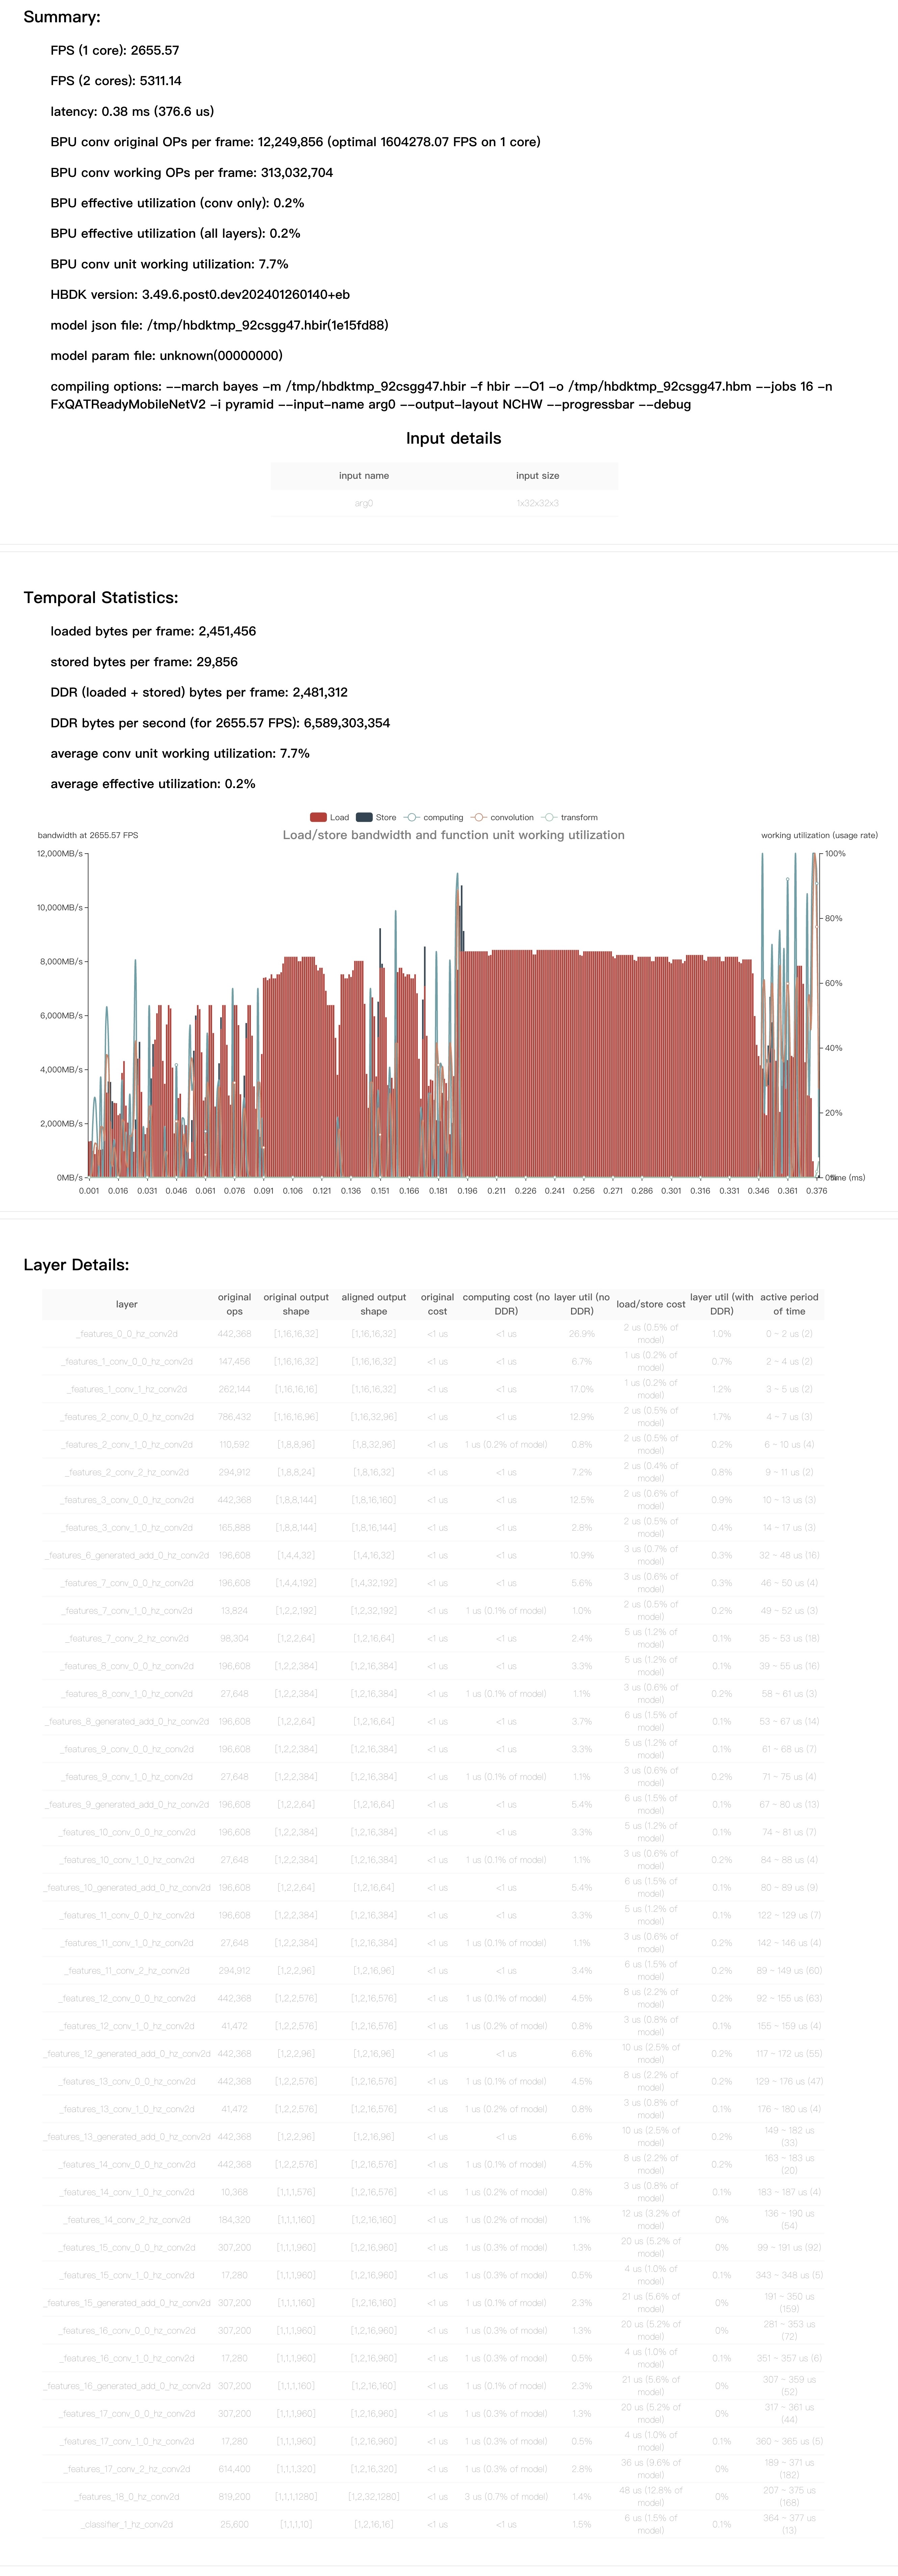
    FPS=2655.57, latency = 376.6 us, DDR = 2481312 bytes   (see model/mobilenetv2/perf_out/FxQATReadyMobileNetV2.html)
HBDK model compilation SUCCESS
HBDK performance estimation SUCCESS
根据
# 模型可视化
visualize_model(
    script_model,
    [example_input],
    save_path=os.path.join(model_path, "model.svg"),
    show=False,
)
INFO: launch 1 threads for optimization
consumed time 0.424022
HBDK model compilation SUCCESS