6.1. 简介
X5算法工具链是基于X5处理器研发的算法解决方案,可以帮助您把浮点模型量化为定点模型, 并在X5上快速部署自研算法模型。
目前在GPU上训练的模型大部分都是浮点模型,即参数使用的是float类型存储;X5处理器中BPU使用的是INT8的计算精度(业内处理器的通用精度),只能运行定点量化模型。从训练出的浮点模型转为定点模型的过程,我们叫做量化,依据是否要对量化后的参数进行调整,我们可以将量化方法分为QAT(Quantification Aware Training)量化感知训练和PTQ(Post-Training Quantization)训练后量化。这两种方法的操作区别如下图所示(图左为PTQ,图右为QAT):
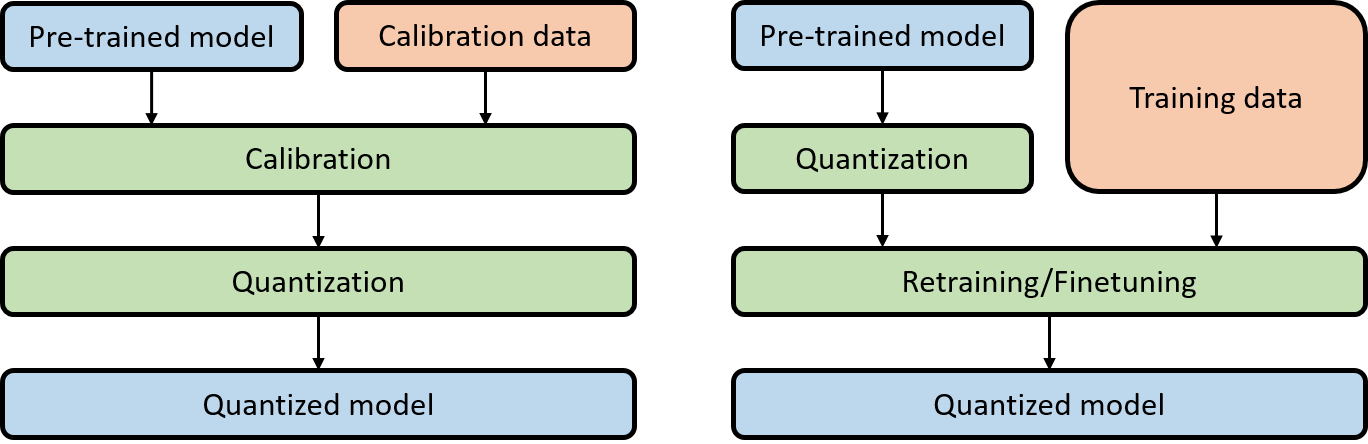
训练后量化PTQ方法是只需使用一批校准数据对训练好的浮点模型进行校准, 将训练过的FP32网络直接转换为定点计算的网络,此过程中无需对原始浮点模型进行任何训练,只对几个超参数调整就可完成量化过程, 整个过程简单快速, 目前在端侧和云侧场景已得到广泛应用。有关PTQ方案的详细信息请阅读 训练后量化(PTQ) 章节内容。
量化感知训练QAT是将训练过的模型量化后又再进行重训练。由于定点数值无法用于反向梯度计算,实际操作过程是在某些OP前插入伪量化节点(fake quantization nodes), 用于在训练时获取流经该OP的数据的截断值,便于在部署量化模型时对节点进行量化时进行使用。我们需要在训练中通过不断优化精度来获取最佳的量化参数。由于它需要对模型进行训练,因此对操作人员技术要求较高。 有关QAT方案的详细信息请阅读 量化感知训练(QAT)章节内容。
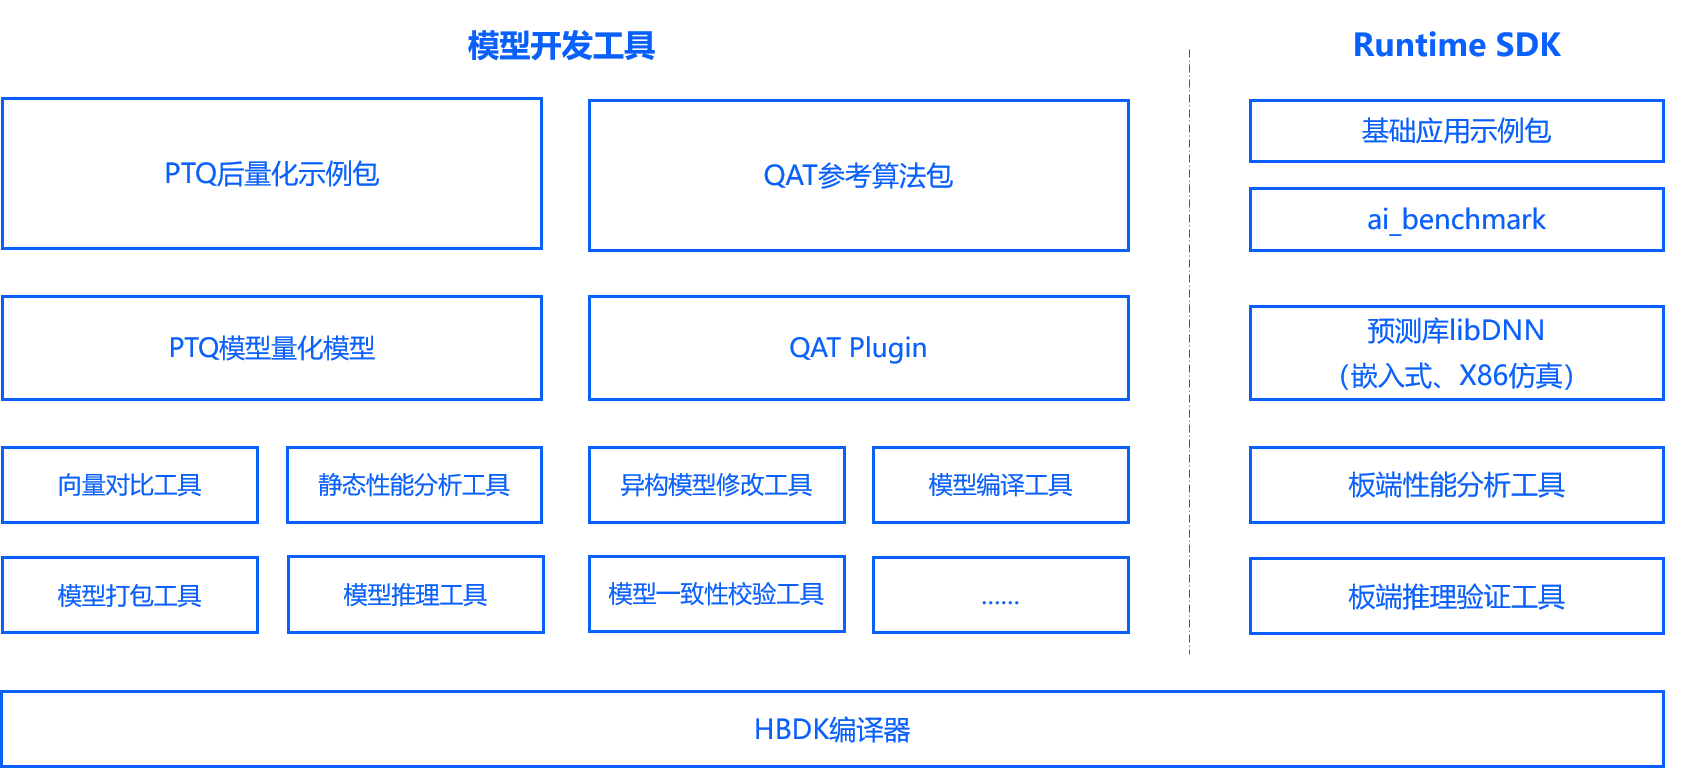
工具链由PTQ、QAT和嵌入式编译等部分组成,工具链组成示意图如下:
6.1.1. 使用注意事项
本章节适用于使用X5处理器的开发者,用于介绍X5算法工具链的一些使用注意事项。
6.1.1.1. 浮点模型(FP32)注意事项
支持caffe 1.0 版本的caffe浮点模型和ir_version≤7 、opset10 、opset11 版本的onnx浮点模型量化成X5处理器支持的定点模型;
其他框架训练的浮点模型需要先导出第1点要求符合版本的onnx浮点模型后,才能进行量化;
模型输入维度只支持固定4维 输入NCHW或NHWC,例如:1x3x224x224或1x224x224x3, 不支持动态维度及非4维输入;
浮点模型中不要包含有后处理算子 ,例如:nms计算。