6.3.2. PTQ原理及步骤详解
6.3.2.1. 简介
模型
配合X5算法
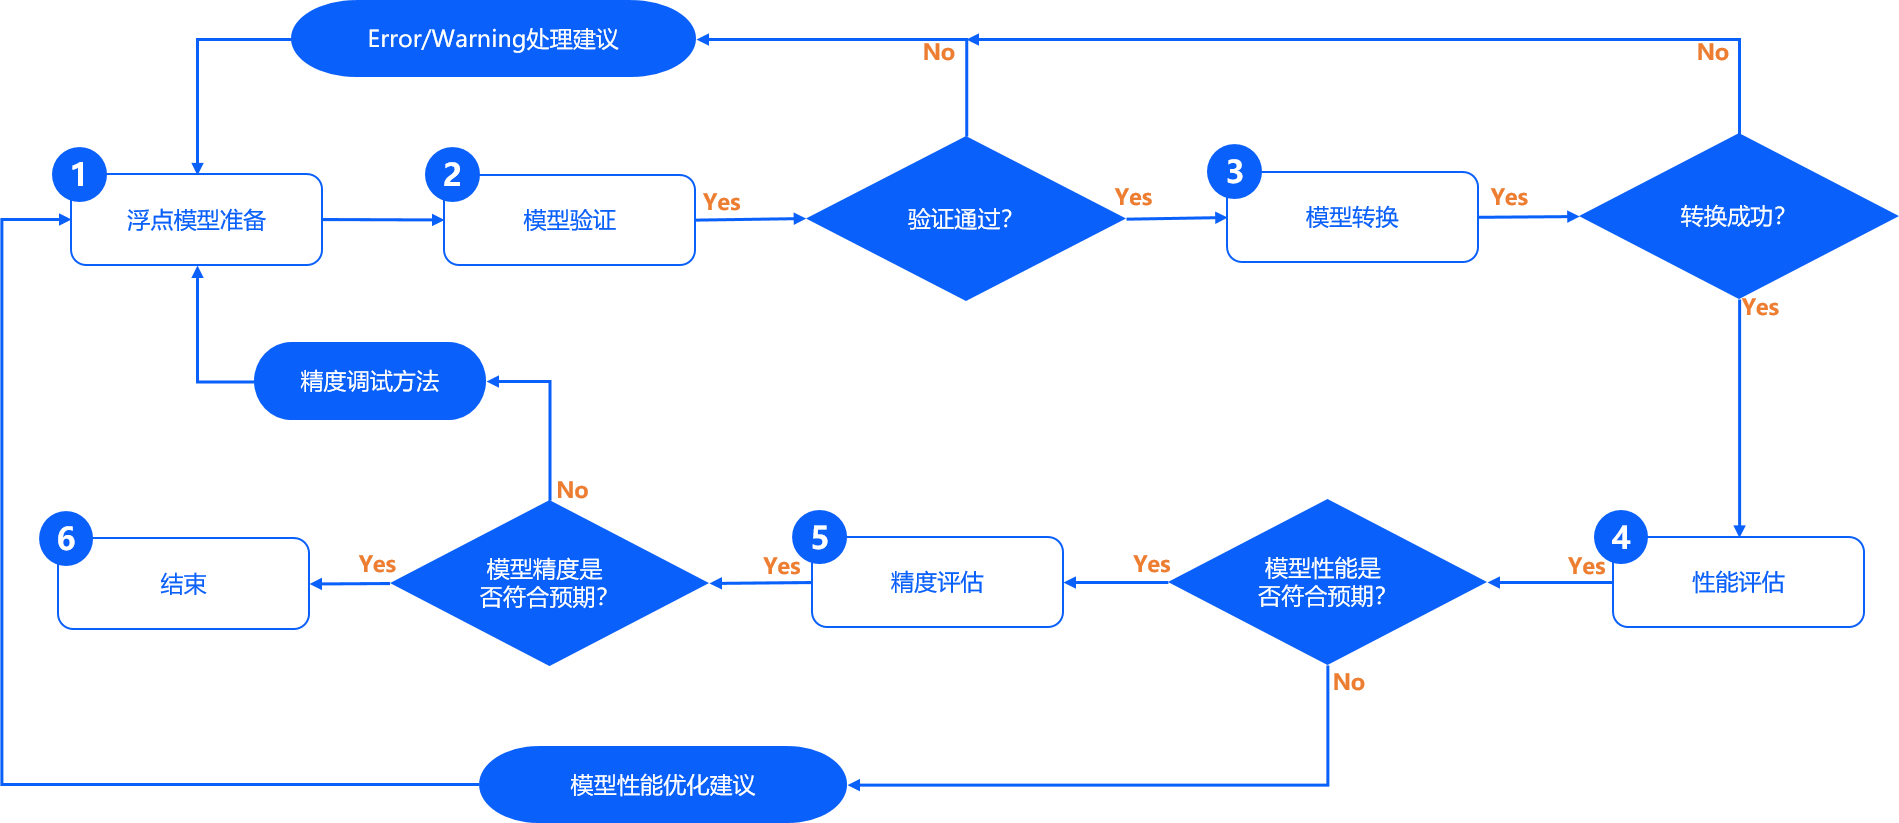
浮点
模型hb_mapper checker 检查
模型hb_mapper makertbin 转换
性能
精度
6.3.2.2. 模型准备
基于
| 框架 | Caffe | PyTorch | TensorFlow | MXNet | PaddlePaddle |
|---|---|---|---|---|---|
| X5算法 |
支持 | 支持(转ONNX) | 支持(转ONNX) | 支持(转ONNX) | 支持(转ONNX) |
以上
对于
小
关于Pytorch、PaddlePaddle、TensorFlow2框架
注意:
6.3.2.3. 模型验证
模型hb_mapper checker 工具
小
建议
参考 使用X5算法 工具链 模型 转换 horizon_model_convert_sample示例包中 的caffe、onnx等 示例 模型 的 脚本 方法: 01_check.sh。
使用 hb_mapper checker 工具验证模型
hb_mapper checker 工具的使用方式如下:
hb_mapper checker --model-type ${model_type} \
                  --march ${march} \
                  --proto ${proto} \
                  --model ${caffe_model/onnx_model} \
                  --input-shape ${input_node} ${input_shape} \
                  --output ${output}
hb_mapper checker 参数
–model-type
用于caffe 或者 onnx。
–march
用于bayes-e。
–proto
此参数model-type 指定 caffe 时
–model
在 model-type 被caffe 时,取值model-type 被onnx 时,取值
–input-shape
可{input_name} {NxHxWxC/NxCxHxW} ,input_name 与shape之间data1,输入shape为 [1,224,224,3],
则--input-shape data1 1x224x224x3。
如果
注意:
一个
--input-shape只接受 一个name和shape组合,如果 您 的 模型 有 多个 输入 节点,在 命令 中 多次 配置 --input-shape参数即可。 --output参数
已经 废弃,log信息 默认 存储 于 hb_mapper_checker.log中。
检查异常处理
如果hb_mapper_checker.log 日志
例如:以下Accuracy:
  layer {
    name: "data"
    type: "Input"
    top: "data"
    input_param { shape: { dim: 1 dim: 3 dim: 224 dim: 224 } }
  }
  layer {
    name: "Convolution1"
    type: "Convolution"
    bottom: "data"
    top: "Convolution1"
    convolution_param {
      num_output: 128
      bias_term: false
      pad: 0
      kernel_size: 1
      group: 1
      stride: 1
      weight_filler {
        type: "msra"
      }
    }
  }
  layer {
    name: "accuracy"
    type: "Accuracy"
    bottom: "Convolution3"
    top: "accuracy"
    include {
      phase: TEST
    }
  }
使用 hb_mapper checker 检查hb_mapper_checker.log 中
ValueError: Not support layer name=accuracy type=Accuracy
注意:
如果
模型 检查 步骤 异常 终止 或者 出现 报错 信息,则 说明 模型 验证 不 通过,请 根据 终端 打印 或 在 当前 路径 下 生成 的 hb_mapper_checker.log日志文件 确认 报错 信息 和 修改 建议,错误信息 可以 在 模型 量化 章节错误 及 解决 方法 来 查找 错误 的 解决 方法,若 以上 步骤 仍 不能 排除 问题,请 联系 技术支持 团队 或 在官方 技术 提出社区 您 的 问题,我们 将 在24小时 内 给 您 提供 支持。
检查结果解读
如果hb_mapper checker 工具
  ==============================================
  Node         ON   Subgraph  Type
  ----------
  conv1        BPU  id(0)     HzSQuantizedConv
  conv2_1/dw   BPU  id(0)     HzSQuantizedConv
  conv2_1/sep  BPU  id(0)     HzSQuantizedConv
  conv2_2/dw   BPU  id(0)     HzSQuantizedConv
  conv2_2/sep  BPU  id(0)     HzSQuantizedConv
  conv3_1/dw   BPU  id(0)     HzSQuantizedConv
  conv3_1/sep  BPU  id(0)     HzSQuantizedConv
  ...
结果
检查结果的调优指导
在hb_mapper checker 工具
以下
在 X5 上 运行 的ONNX模型 出现 了Mul + Add + Mul的 结构,从 X5 的 算子 约束 列表 中 我们 可以 看到,Mul和Add算子 在 五维 上 是 支持BPU运行 的,但 前提 要 符合X5 BPU算子 约束条件,不然 就 会 回退 到CPU计算。
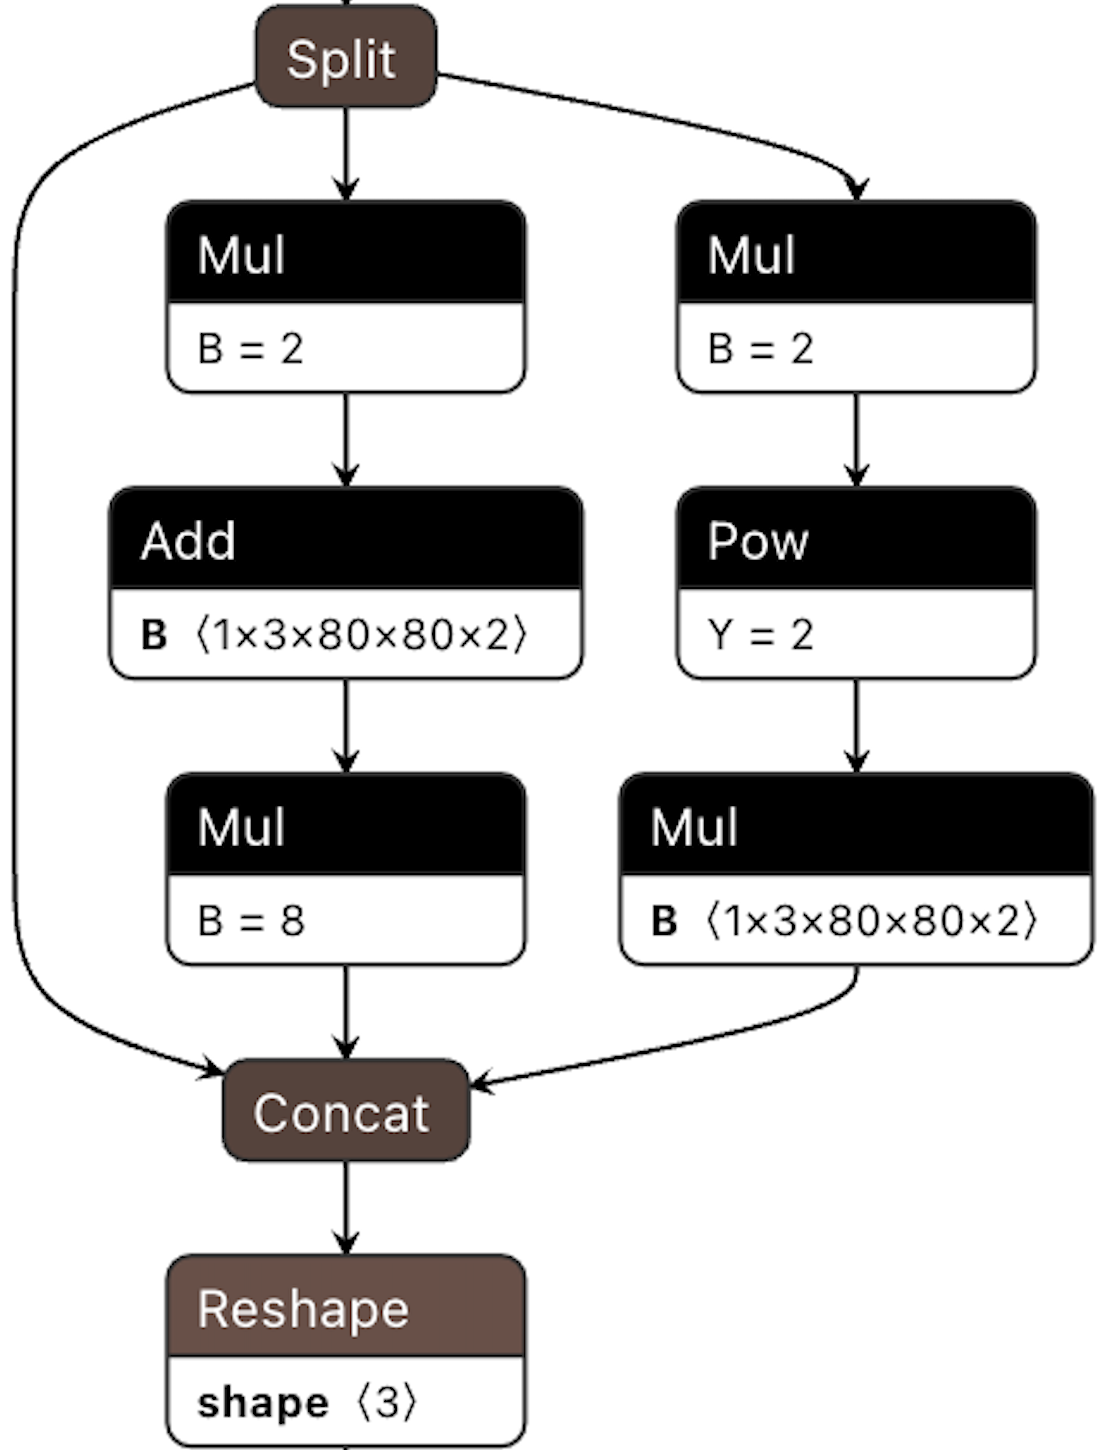
因此
  ====================================================================================
  Node                                    ON   Subgraph  Type
  -------------------------------------------------------------------------------------
  Reshape_199                             BPU  id(0)     Reshape
  Transpose_200                           BPU  id(0)     Transpose
  Sigmoid_201                             BPU  id(0)     HzLut
  Split_202                               BPU  id(0)     Split
  Mul_204                                 CPU  --        Mul
  Add_206                                 CPU  --        Add
  Mul_208                                 CPU  --        Mul
  Mul_210                                 CPU  --        Mul
  Pow_211                                 BPU  id(1)     HzLut
  Mul_213                                 CPU  --        Mul
  Concat_214                              CPU  --        Concat
  Reshape_215                             CPU  --        Reshape
  Conv_216                                BPU  id(0)     HzSQuantizedConv
  Reshape_217                             BPU  id(0)     Reshape
  Transpose_218                           BPU  id(0)     Transpose
  Sigmoid_219                             BPU  id(0)     HzLut
  Split_220                               BPU  id(0)     Split
  Mul_222                                 CPU  --        Mul
  Add_224                                 CPU  --        Add
  Mul_226                                 CPU  --        Mul
  Mul_228                                 CPU  --        Mul
  Pow_229                                 BPU  id(2)     HzLut
  Mul_231                                 CPU  --        Mul
  Concat_232                              CPU  --        Concat
  Reshape_233                             CPU  --        Reshape
  Conv_234                                BPU  id(0)     HzSQuantizedConv
  Reshape_235                             BPU  id(0)     Reshape
  Transpose_236                           BPU  id(0)     Transpose
  Sigmoid_237                             BPU  id(0)     HzLut
  Split_238                               BPU  id(0)     Split
  Mul_240                                 CPU  --        Mul
  Add_242                                 CPU  --        Add
  Mul_244                                 CPU  --        Mul
  Mul_246                                 CPU  --        Mul
  Pow_247                                 BPU  id(3)     HzLut
  Mul_249                                 CPU  --        Mul
  Concat_250                              CPU  --        Concat
  Reshape_251                             CPU  --        Reshape
  Concat_252                              CPU  --        Concat
注意: 这里log结果仅用作示例,在使用过程中,请以您使用的版本实际打印的log情况为准。
根据 hb_mapper checker 给出
当然,多个
6.3.2.4. 模型转换
模型
模型hb_mapper makertbin 工具
准备校准数据
在
转换preprocess_on 参数,该启用 和 关闭 状态preprocess_on 关闭input_type_train )、尺寸( input_shape )和
layout( input_layout_train ),对于featuremap输入numpy.tofile 命令numpy.fromfile 命令
输入
类型: BGR输入layout:
NCHW输入
尺寸: 1x3x224x224
使用
图像
长宽 等 比scale,短边 缩 放到256。 center_crop方法获取224x224大小 图像。 按
通道 减mean。 数据
乘以scale系数。
针对
为
小
建议
参考 使用X5算法 工具链 模型 转换 horizon_model_convert_sample示例包中 的caffe、onnx等 示例 模型 的 预处理 步骤 方法: 02_preprocess.sh和preprocess.py。
# 本示例使用skimage,如果是opencv会有所区别
# 需要您特别注意的是,transformers中并没有体现减mean和乘scale的处理
# mean和scale操作已经融合到了模型中,请参考下文norm_type/mean_value/scale_value配置
def data_transformer():
    transformers = [
    # 长宽等比scale,短边缩放至256
    ShortSideResizeTransformer(short_size=256),
    # CenterCrop获取224x224图像
    CenterCropTransformer(crop_size=224),
    # skimage读取结果为NHWC排布,转换为模型需要的NCHW
    HWC2CHWTransformer(),
    # skimage读取结果通道顺序为RGB,转换为模型需要的BGR
    RGB2BGRTransformer(),
    # skimage读取数值范围为[0.0,1.0],调整为模型需要的数值范围
    ScaleTransformer(scale_value=255)
    ]

    return transformers

# src_image 标定集中的原图片
# dst_file 存放最终标定样本数据的文件名称
def convert_image(src_image, dst_file, transformers):
    image = skimage.img_as_float(skimage.io.imread(src_image))
    for trans in transformers:
    image = trans(image)
    # 模型指定的input_type_train BGR数值类型是UINT8
    image = image.astype(np.uint8)
    # 二进制存储标定样本到数据文件
    image.tofile(dst_file)

if __name__ == '__main__':
    # 此处表示原始标定图片集合,伪代码
    src_images = ['ILSVRC2012_val_00000001.JPEG',...]
    # 此处表示最终标定文件名称(后缀名不限制),伪代码
    # calibration_data_bgr_f32是您在配置文件中指定的cal_data_dir
    dst_files = ['./calibration_data_bgr_f32/ILSVRC2012_val_00000001.bgr',...]

    transformers = data_transformer()
    for src_image, dst_file in zip(src_images, dst_files):
        convert_image(src_image, dst_file, transformers)
小
preprocess_on启用状态 下,标定 样本 使用skimage支持 读取 的 图片 格式文件 即可。 转换
工具 读取 这些 图片 后,会 将 其缩 放到 模型 输入 节点 要求 的 尺寸 大小,以此 结果 作为 校准 的 输入。 这样
的 操作 会 简单,但是 对于 量化 的 精度 没有 保障,因此 我们 强烈建议 您 使用 关闭 preprocess_on的方式。
注意:
请
注意,yaml文件 中input_shape参数 作用 为 指定 原始 浮点 模型 的 输入 数据 尺寸。若 为 动态 输入 模型 则 可 通过 这个 参数设置 转换 后 的 输入 大小,而 校准 数据 的shape大小 应 与input_shape保持一致。 例如:若
原始 浮点 模型 输入 节点shape为?x3x224x224(“?”号 代表 占位 符,即该 模型 第一 维为 动态 输入), 转换 配置文件 中 设置input_shape: 8x3x224x224,则 用户 需要 准备 的 每份 校准 数据 大小 为 8x3x224x224。 ( 请知悉,此类输入shape第一维不等于1的模型,不支持通过input_batch参数修改模型batch信息。)
使用 hb_mapper makertbin 工具转换模型
hb_mapper makertbin提供fast-perf 模式fast-perf 模式。
fast-perf 模式
将BPU可
执行 算子 尽可能 运行 在BPU上(若 使用 X5则可以 通过yaml文件 中node_info参数 指定 在BPU上 运行 的 算子)。 删除
模型 首尾 不可 删除 的CPU算子,包括:Quantize/Dequantize、Transpose、Cast、Reshape等。 以
性能 最高 的O3优化 等级 编译 模型。
小
建议
参考 使用X5算法 工具链 模型 转换 horizon_model_convert_sample示例包中 的caffe、onnx等 示例 模型 的 脚本 方法: 03_build.sh。
hb_mapper makertbin命令
不fast-perf 模式:
hb_mapper makertbin --config ${config_file}  \
                    --model-type  ${model_type}
开启 fast-perf 模式:
hb_mapper makertbin --fast-perf --model ${caffe_model/onnx_model} --model-type ${model_type} \
                    --proto ${caffe_proto} \
                    --march ${march}
注意: 如--config 参数
hb_mapper makertbin参数
–help
显示
-c, –config
模型
–model-type
用于caffe 或者 onnx。
–fast-perf
开启fast-perf模式,该
如
--model
Caffe或ONNX浮点
--proto
用于
--march
BPU的X5 则bayes-e。
-i, --input-shape
可
指定
单个 输入 节点 的shape信息,使用 方式 为 --input-shape input_1 1x3x224x224。指定
多个 输入 节点 的shape信息,使用 方式 为 --input-shape input_1 1x3x224x224 --input-shape input_2 1x3x224x224。
注意: 如--input-shape 参数,此时
编译hb_mapper_makertbin.log。
注意:
X5 yaml配置文件,可直接 使用X5 Caffe模型 量化yaml文件 和X5 ONNX模型模板 量化yaml文件 模板模板 文件 进行 填写。 若 hb_mapper makertbin 步骤
异常 终止 或者 出现 报错 信息,则 说明 模型 转换 失败,请 根据 终端 打印 或 在 当前 路径 下 生成 的 hb_mapper_makertbin.log日志文件 确认 报错 信息 和 修改 建议,若 以上 步骤 仍 不能 排除 问题,请 联系 技术支持 团队 或 在官方 技术 提出社区 您 的 问题,我们 将 在24小时 内 给 您 提供 支持。
模型转换yaml配置参数说明
注意:
要么
是Caffe模型,要么 是ONNX模型。即 caffe_model+prototxt或者onnx_model二选一。 即,要么 是Caffe模型,要么 是ONNX模型。
# 模型参数组
model_parameters:
  # 原始Caffe浮点模型描述文件
  prototxt: '***.prototxt'

  # 原始Caffe浮点模型数据模型文件
  caffe_model: '****.caffemodel'

  # 原始Onnx浮点模型文件
  onnx_model: '****.onnx'

  # 转换的目标处理器架构,保持默认
  march: 'bayes-e'

  # 模型转换输出的用于上板执行的模型文件的名称前缀
  output_model_file_prefix: 'mobilenetv1'

  # 模型转换输出的结果的存放目录
  working_dir: './model_output_dir'

  # 指定转换后混合异构模型是否保留输出各层的中间结果的能力,保持默认即可
  layer_out_dump: False

  # 指定模型的输出节点
  output_nodes: {OP_name}

  # 批量删除某一类型的节点
  remove_node_type: Dequantize

  # 删除指定名称的节点
  remove_node_name: {OP_name}

# 输入信息参数组
input_parameters:
  # 原始浮点模型的输入节点名称
  input_name: "data"

  # 原始浮点模型的输入数据格式(数量/顺序与input_name一致)
  input_type_train: 'bgr'

  # 原始浮点模型的输入数据排布(数量/顺序与input_name一致)
  input_layout_train: 'NCHW'

  # 原始浮点模型的输入数据尺寸
  input_shape: '1x3x224x224'

  # 网络实际执行时,输入给网络的batch_size, 默认值为1
  input_batch: 1

  # 在模型中添加的输入数据预处理方法
  norm_type: 'data_mean_and_scale'

  # 预处理方法的图像减去的均值, 如果是通道均值,value之间必须用空格分隔
  mean_value: '103.94 116.78 123.68'

  # 预处理方法的图像缩放比例,如果是通道缩放比例,value之间必须用空格分隔
  scale_value: '0.017'

  # 转换后混合异构模型需要适配的输入数据格式(数量/顺序与input_name一致)
  input_type_rt: 'yuv444'

  # 输入数据格式的特殊制式
  input_space_and_range: 'regular'

  # 转换后混合异构模型需要适配的输入数据排布(数量/顺序与input_name一致),若input_type_rt配置为nv12,则此处参数不需要配置
  input_layout_rt: 'NHWC'

# 校准参数组
calibration_parameters:
  # 模型校准使用的标定样本的存放目录
  cal_data_dir: './calibration_data'

  # 指定校准数据二进制文件的数据存储类型。
  cal_data_type: 'float32'

  # 开启图片校准样本自动处理(skimage read; resize到输入节点尺寸)
  #preprocess_on: False

  # 校准使用的算法类型, 优先使用的 default 校准算法
  calibration_type: 'default'

  # max 校准方式的参数
  # max_percentile: 1.0

  # 强制指定OP在CPU上运行,一般不需要配置,在模型精度调优阶段可以开启此功能,用于尝试精度优化
  #run_on_cpu:  {OP_name}

  # 强制指定OP在BPU上运行, 一般不需要配置,在模型性能调优阶段可以开启此功能,用于尝试性能优化
  # run_on_bpu:  {OP_name}

  # 指定是否针对每个channel进行校准
  #per_channel: False

  # 指定输出节点的数据精度
  #optimization: set_model_output_int8

# 编译参数组
compiler_parameters:
  # 编译策略选择
  compile_mode: 'latency'

  # 是否打开编译的debug信息,保持默认的 False
  debug: False

  # 模型运行核心数
  core_num: 1

  # 模型编译的优化等级选择,保持默认的 O3
  optimize_level: 'O3'

  # 指定名称为data的输入数据来源
  #input_source: {"data": "pyramid"}

  # 指定模型的每个function call的最大可连续执行时间
  #max_time_per_fc: 1000

  # 指定编译模型时的进程数
  #jobs: 8

# 此参数组,无需配置,只在有自定义CPU算子时开启使用
#custom_op:
  # 自定义op的校准方式, 推荐使用注册方式 register
  #custom_op_method: register

  # 自定义OP的实现文件, 多个文件可用";"分隔, 该文件可由模板生成, 详情见自定义OP相关文档
  #op_register_files: sample_custom.py

  # 自定义OP实现文件所在的文件夹, 请使用相对路径
  #custom_op_dir: ./custom_op
配置文件
具体param_name: 'param_value' ;
若';' 符号param_name: 'param_value1; param_value2; param_value3' ;具体run_on_cpu: 'conv_0; conv_1; conv12' 。
小
当
模型 为 多 输入 模型 时, 建议 用户 将 可 选 参数( input_name,input_shape等)显式的 写出, 以免 造成 参数 对应 顺序 上 的 错误。 在
配置march为 bayes-e,即在 进行X5模型 转换 时,如 您 将 优化 等级optimize_level配置 为O3,hb_mapper makertbin默认 提供 缓存 能力。即 在 您 第一次 使用hb_mapper makertbin对模型 进行 编译 时,会 自动 创建 缓存 文件,后续 在 您 的working_dir不变 的 情况 下,在 重复 编译 时会 自动 调用 此 文件,降低 您 的 编译 时间。
注意:
请
注意,如果 设置 input_type_rt为nv12或yuv444,则模型 的 输入 尺寸 中 不能 出现 奇数。模型
转换 成功 后,若 出现 符合X5BPU算子 约束条件 的OP仍然 运行 在CPU上,其 主要 原因 是 该OP属于 被动 量化OP,关于 被动 量化 相关 内容,请 阅读 算法 工具链 章节。中 的 主动 量化 和 被动 量化 逻辑
以下
模型参数组
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
prototxt |
参数 参数 hb_mapper makertbin的model-type 为 caffe 时 |
取值 默认 |
可 |
caffe_model |
参数 参数 hb_mapper makertbin 的model-type 为 caffe 时 |
取值 默认 |
可 |
onnx_model |
参数 参数 hb_mapper makertbin 的model-type 为 onnx 时 |
取值 默认 |
可 |
march |
参数 参数 |
取值bayes-e。默认 |
必选 |
output_model_file_prefix |
参数 参数 |
取值 默认 |
必选 |
working_dir |
参数 参数 |
取值 默认 model_output。 |
可 |
layer_out_dump |
参数 参数 |
取值True 、 False。默认 False。 |
可 |
output_nodes |
参数 参数 param_value 配置 |
取值 默认 |
可 |
remove_node_type |
参数 参数 |
取值 默认 |
可 |
remove_node_name |
参数 参数 |
取值 默认 |
可 |
set_node_data_type |
参数 参数 注意: 该 node_info 参数 |
取值 默认 |
可 |
debug_mode |
参数 参数 |
取值"dump_calibration_data"默认 |
可 |
node_info |
参数 参数 set_node_data_type 、run_on_cpu 和 run_on_bpu 三个node_info 参数- 仅 node_info: { "node_name": { 'ON': 'BPU', } } - 仅 node_info: 'node_name1:int16;node_name2:int16' 多个 param_value配置 <param_value>。 - 指定OP运行 node_info: { "node_name": { 'ON': 'BPU', 'InputType': 'int16', 'OutputType': 'int16' } } 'InputType': 'int16'代表 如需 'InputType0': 'int16'代表 'InputType1': 'int16'代表 注意: 'OutputType' 不 |
取值 默认 |
可 |
输入信息参数组
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
input_name |
参数 参数 |
取值 默认 |
可 |
input_type_train |
参数 参数 input_name里param_value配置 |
取值rgb、bgr、yuv444、gray、featuremap。默认 |
必选 |
input_layout_train |
参数 参数 input_name 里param_value配置 |
取值 默认 |
必选 |
input_type_rt |
参数 参数 input_name里param_value配置 |
取值rgb、bgr、yuv444、nv12、gray、featuremap。默认 |
必选 |
input_layout_rt |
参数 参数 input_name里param_value配置 |
取值NCHW、 NHWC。默认 |
可 |
input_space_and_range |
参数 参数 |
取值regular , bt601_video。默认 regular。 |
可 |
input_shape |
参数 参数 input_name里param_value配置 |
取值 默认 |
可 |
input_batch |
参数 参数 input_shape 第一input_shape 第一此参数 |
取值1-4096。默认 1。 |
可 |
norm_type |
参数 参数 no_preprocess 表示data_mean 表示data_scale 表示data_mean_and_scale 表示input_name里param_value配置 |
取值data_mean_and_scale 、 data_mean 、data_scale 、 no_preprocess。默认 |
必选 |
mean_value |
参数 参数 norm_type 存在 data_mean_and_scale 或 data_mean 时'None'。多个param_value配置 |
取值 默认 |
可 |
scale_value |
参数 参数 norm_type 存在 data_mean_and_scale 或 data_scale 时norm_type 配置scale 处理,则'None'。多个param_value 配置 |
取值 默认 |
可 |
input_type_rt/input_type_train补充
X5的
假设
输入 的 数据 都 是int8的 量化 数据。 摄像头
获取 到 的 数据 是nv12。
因此,如果
  input_parameters:
      input_type_rt: 'nv12'
      input_type_train: 'rgb'
      input_layout_train: 'NCHW'
小
若
您 在 训练 模型 时 使用gray格式,而 实际 使用 中 输入 的 数据格式 为nv12格式,则 可以 将 模型 转换 时 的 input_type_rt及input_type_train均配置 为 gray,在嵌入式应用 开发 时仅 使用nv12的y通道 地址 作为 输入 即可。
校准参数组
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
cal_data_dir |
参数 参数 input_name 里param_value 配置load, skip 时,cal_data_dir不用_f32 结尾,则 |
取值 默认 |
calibration_type非 load、skip时 |
cal_data_type |
参数 参数 |
取值float32、uint8、int32、int16、int8。默认 |
可 |
preprocess_on |
参数 参数 |
取值True 、 False。默认 False。 |
可 |
calibration_type |
参数 参数 kl 和 max 都load 方式mix 是default 是default, 如果 |
取值default、mix`、```kl、max、load 和 skip。默认 default。 |
必选 |
max_percentile |
参数max 校准max 校准参数 calibration_type 为 max 时calibration_type 配置 default, 如果 |
取值0.5~1.0 。默认 1.0 。 |
可 |
per_channel |
参数 参数 calibration_type 设置default, 如果 |
取值True 、 False。默认 False。 |
可 |
run_on_cpu |
参数 参数 param_value 配置注意: X5 中该 node_info 参数 |
取值 默认 |
可 |
run_on_bpu |
参数 参数 param_value 配置注意: X5 中该 node_info 参数 |
取值 默认 |
可 |
optimization |
参数 参数 - 指定 - 指定 - 指定 - 指定 - 指定 - 指定 - 指定 - 指定 |
取值set_model_output_int8 、 set_model_output_int16、set_{NodeKind}_input_int16、 set_{NodeKind}_output_int16、set_Softmax_input_int8、 set_Softmax_output_int8、asymmetric、 bias_correction、 lstm_batch_last 注意:此处 Nodekind 为默认 |
可 |
preprocess_on补充
如果
指定 配置 参数 preprocess_on=True:工具
可 通过 该 设置 preprocess_on为True来自动 完成 的 校准 图片 的 前 处理。 该 模式 下 需 在 cal_data_dir中指定 校准JPEG图片 的 存放 路径。 则 在 模型 校准 时,工具 内部 会 通过skimage方式 读入 的JPEG图片,通过skimage resize的 方式 缩放 图片 到 配置文件 指定 的 input_shape, 并把 图像格式 调整 为 input_type_rt指定的 格式。 举
一个 例子,假如 输入 的JPEG图像 的 尺寸 为608x608,则 通过 默认 的 预处理 后,图像 被 缩放 为224x224, 图像 的 内存 格式 调整 为bgr(NCHW)的 格式,像素 值 调整 为0-255范围。 默认
的 预处理,请 参考 如下 代码: def data_transformer(norm_type, input_dim, input_type_train): image_width = input_dim[2] image_height = input_dim[1] transformers = [ ResizeTransformer((image_height, image_width)), HWC2CHWTransformer(), # to CXHXW RGB2BGRTransformer(), ] transformers.append(ScaleTransformer(255))如果
指定 配置 参数 preprocess_on=False:您
需要 自行处理 图片,将 图片 处理 为 input_type_train指定的 格式,并且 将 数据 以 二进制 形式 保存 为 文件。 工具 内部 会 自动 增加 从 input_type_train到input_type_rt的格式 转换。
备注: 文件格式
编译参数组
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
compile_mode |
参数 参数 latency 以bandwidth 以latency 策略。balance 平衡 |
取值latency、 bandwidth、 'balance'。默认 latency。 |
必选 |
balance_factor |
参数 参数 |
取值0-100。默认 |
compile_mode 为balance 时 |
debug |
参数 参数 |
取值True 、 False。默认 False。 |
可 |
core_num |
参数 参数 core_num=2。注意: X5 该 |
取值1、 2 。默认 1。 |
可 |
optimize_level |
参数 参数 O0 ~ O3。O0 不O1 - O3 随着O3 级别 |
取值O0 、 O1 、 O2 、 O3。默认 |
必选 |
input_source |
参数 参数 ddr 表示pyramid 和 resizer 表示pyramid 和 resizer 数据源, 此参数{"data": "ddr"}。 |
取值ddr, pyramid, resizer默认 |
可 |
max_time_per_fc |
参数 参数 - 模型 |
取值0或1000-4294967295。默认 0。 |
可 |
jobs |
参数 参数 |
取值机器支持的最大核心数范围内。默认 |
可 |
advice |
参数 参数 |
取值 默认 |
可 |
自定义算子参数组
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
custom_op_method |
参数 参数 |
取值register。默认 |
可 |
op_register_files |
参数 参数 ; 分隔 |
取值 默认 |
可 |
custom_op_dir |
参数 参数 |
取值 默认 |
可 |
X5 int16配置说明
在node_info 参数,
可以
在
预处理HzPreprocess算子说明
预处理HzPreprocess算子norm_type 、 mean_value 、 scale_value 参数
norm_type参数
参数
作用:此参数 为 在 模型 中 添加 的 输入 数据 预处理 方法。 参数
取值 范围 及 说明: no_preprocess表示不 添加 任何 数据 预处理。 data_mean表示提供 减 均值 预处理。 data_scale表示提供 乘scale系数 预处理。 data_mean_and_scale表示提供 先减 均值 再 乘scale系数 前 处理。
注意:
当input_name 中
mean_value参数
参数
作用:此参数 表示 指定 预处理 方法 的 图像 减去 的 均值。 使用
说明:当 norm_type取值为 data_mean_and_scale或data_mean时需要 配置 该 参数。 参数
说明: 当
只有 一个 输入 节点 时,仅 需要 配置 一个 数值,表示 所有 通道 都 减去 这个 均值。 当有
多个 节点 时,提供 与 通道 数量 一致 的 数值(这些 数值 以 空格 分 隔开),表示 每个 通道 都 会 减去 不同 的 均值。
注意:
配置
的 输入 节点 数量 必须 与 norm_type配置的 节点 数量 一致。
如果
存在 某个 节点 不 需要 mean处理,则为 该 节点 配置 'None'。
scale_value参数
参数
作用:此参数 表示 指定 预处理 方法 的 数值scale系数。 使用
说明:当 norm_type取值为 data_mean_and_scale或data_scale时需要 配置 该 参数。 参数
说明: 当
只有 一个 输入 节点 时,仅 需要 配置 一个 数值,表示 所有 通道 都 乘以 这个 系数。 当有
多个 节点 时,提供 与 通道 数量 一致 的 数值(这些 数值 以 空格 分 隔开),表示 每个 通道 都 会 乘以 不同 的 系数。
注意:
配置
的 输入 节点 数量 必须 与 norm_type配置的 节点 数量 一致。
如果
存在 某个 节点 不 需要 scale处理,则为 该 节点 配置 'None'。
计算公式
模型
训练 时 的 数据 标准化 处理 计算公式
yaml文件
预处理norm\_data = ( data − mean ) * scale。
以yolov3为例,其
def base_transform(image, size, mean, std):
    x = cv2.resize(image, (size, size).astype(np.float32))
    x /= 255
    x -= mean
    x /= std
    return x

class BaseTransform:
    def __init__(self, size, mean=(0.406, 0.456, 0.485), std=(0.225, 0.224, 0.229)):
        self.size = size
        self.mean = np.array(mean, dtype=np.float32)
        self.std = np.array(std, dtype=np.float32)
则
改写
则:\(mean_yaml = 255 mean、𝑠𝑐𝑎𝑙𝑒_𝑦𝑎𝑚𝑙= \frac{1}{255 𝑠𝑡𝑑}\)。
模型
推理 时 的 计算公式
通过
HzPreprocess内((input(取值范围[-128,127])+ 128) - mean) * scale,其中 weight=scale, bias=(128-mean) * scale 。
注意:
在yaml中
添加mean/scale后,就 不 需要 在 前 处理 内 添加MeanTransformer和ScaleTransformer。 在yaml中
添加mean/scale,会 将 参数 放入 到HzPreprocess节点 内,HzPreprocess节点 为 BPU 节点。
[参考]支持的校准方法
目前
1.default
default 是
2.mix
mix 是
3.KL
KL 校准
4.max
max 校准
5.load
使用 QAT 导出
6.skip
若skip 方式
注意: 需要skip 方式
转换内部过程解读
模型
输入
针对
每个
转换 的 模型 都 提供 两种 描述,一种 用于 描述 原始 浮点 模型 的 输入 数据( input_type_train和input_layout_train),另一种 则 用于 描述 我们 需要 对接 的 处理器 的 输入 数据( input_type_rt和input_layout_rt)。图像
数据 的mean/scale也 是 比较 常见 的 操作,但YUV420 NV12等 处理器 支持 的 数据格式 不 适合 这样 的 操作,因此,我们 也 将 这些 常见 图像 前 处理 固化 到 了 模型 中。
经过***.bin 异构
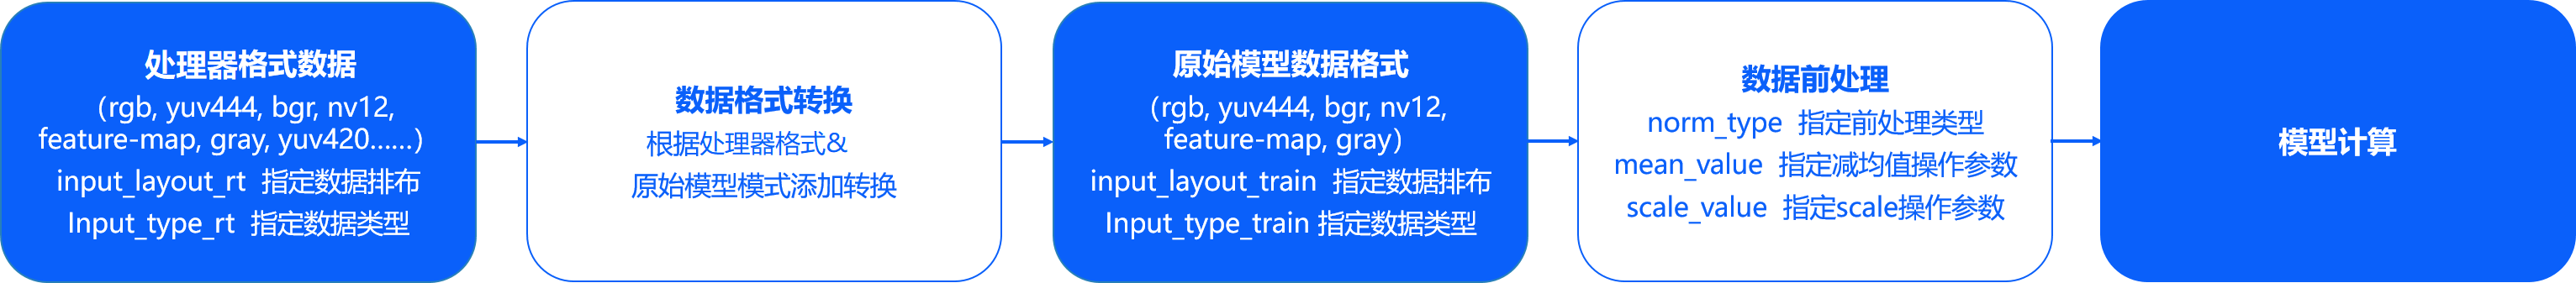
上input_layout_train 必须input_layout_rt 一致
模型input_type_rt 和 input_type_train 指定
input_type_train \ input_type_rt |
nv12 | yuv444 | rgb | bgr | gray | featuremap |
|---|---|---|---|---|---|---|
| yuv444 | Y | Y | N | N | N | N |
| rgb | Y | Y | Y | Y | N | N |
| bgr | Y | Y | Y | Y | N | N |
| gray | N | N | N | N | Y | N |
| featuremap | N | N | N | N | N | Y |
备注:
表格
中 第一行 是 input_type_rt中支持 的 类型,第一列 是 input_type_train支持的 类型, 其中 的 Y/N 表示 是否 支持 相应 的 input_type_rt到input_type_train的转换。 为了
配合 计算 平台 对于 输入 数据类型 的 要求(int8),减小 推理 开销,对于 input_type_rt类型为 rgb(NHWC/NCHW)/bgr(NHWC/NCHW) 的 配置, 转换 工具 转换 出 的 模型,其 输入 数据类型 均 为 int8。 也就是说,对于常规 的 图像 数据,需要-128使用(该 操作 在API中 已 自动 进行,无需 再 进行 该 操作)。 在
模型 转换 得到 的 最终 产出bin模型 中, input_type_rt到input_type_train是一个 内部 的 过程, 您 只 需要 关注 input_type_rt的数据格式 即可。 正确理解
每种 input_type_rt的要求,对于 嵌入式应用 准备 推理 数据 很 重要,以下 是 对 input_type_rt每种格式 的 说明: rgb、bgr和gray都
是 比较 常见 的 图像格式,注意 每个 数值 都 采用UINT8表示。 yuv444是
一种 常见 的 图像格式,注意 每个 数值 都 采用UINT8表示。 nv12是
常见 的yuv420图像格式,每个 数值 都 采用UINT8表示。 nv12有个
比较 特别 的 情况 是 input_space_and_range设置bt601_video(参考前 文 对 input_space_and_range参数的 介绍),较于 常规nv12情况,它 的 数值 范围 由[0,255]变成 了[16,235], 每个 数值 仍然 采用UINT8表示。 featuremap输入
模型 的 数据格式type只 要求 您 的 数据 是 四维 的,每个 数值 采用float32表示。例如:雷达 和 语音 等 模型 处理 就 常用 这个 格式。
小
校准
数据 只 需 处理 到input_type_train即可,同时 也 要 注意 不要 做 。重复 的norm操作 以上
input_type_rt与input_type_train是固化 在 算法 工具链 的 处理 流程 中,如果 您 非常 确定 不 需要 转换, 可 将 两个 input_type设置成 相同 的 配置,这样 input_type会做 直通 处理,不会 影响 模型 的 实际 执行 性能。 同样
的,数据 前 处理 也 是 固化 在 流程 中,如果 您 不 需要 做 任何 前 处理,通过 norm_type配置关闭 这个 功能 即可,不会 影响 模型 的 实际 执行 性能。
模型
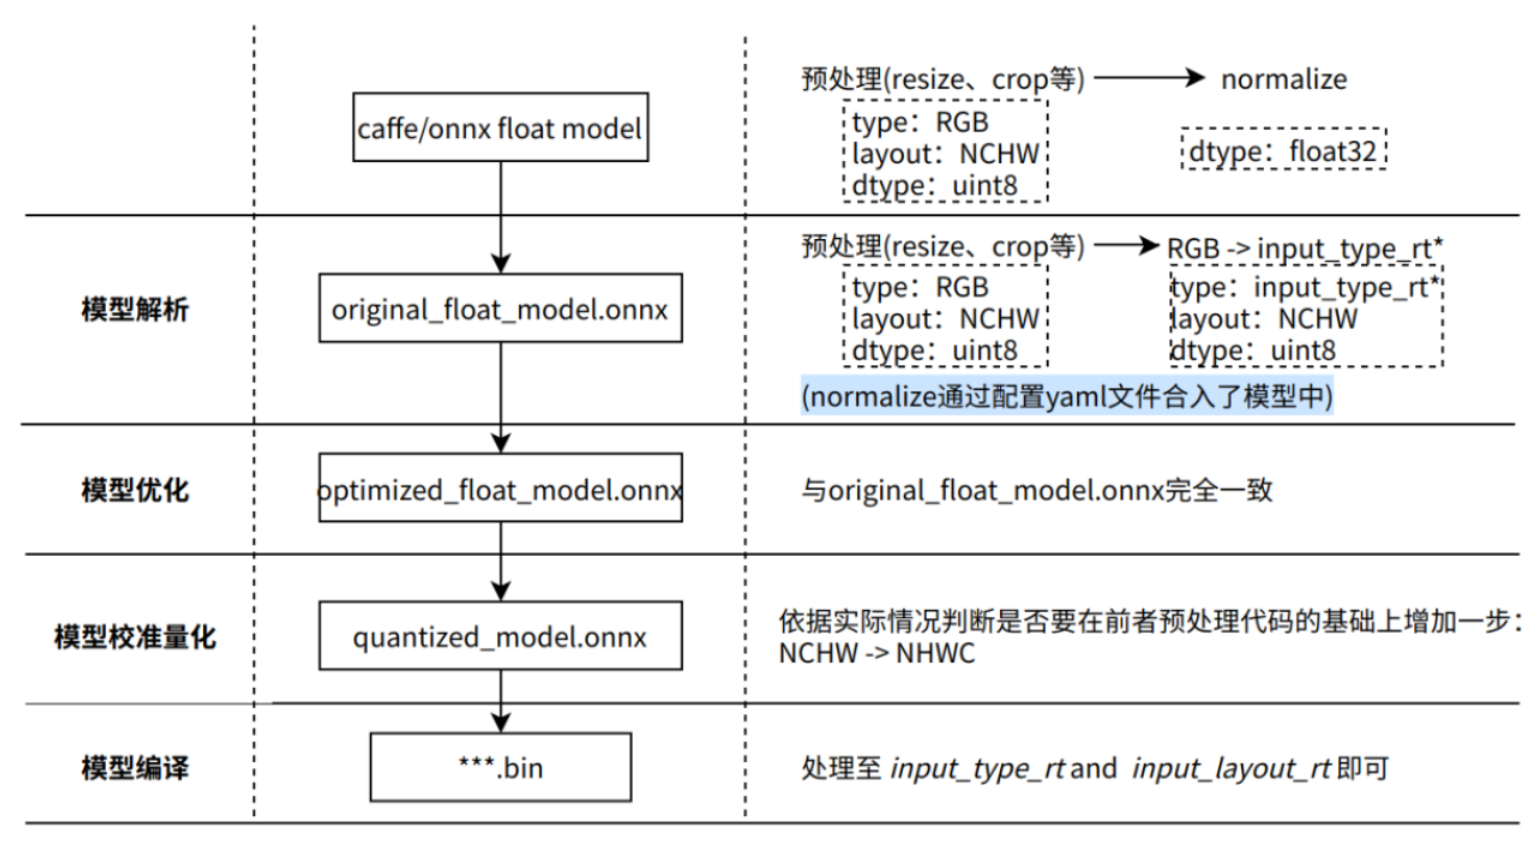
备注:
input_type_rt*表示input_type_rt的中间 格式。 请
用 可视化 工具Netron查看 quantized_model.onnx输入节点 的 数据 排布,决定 是否 要 在 预处理 中 增加 layout转换。
模型
理想input_type_rt 到 input_type_train 的input_type_rt 的input_type_rt 都
| nv12 | yuv444 | rgb | bgr | gray | featuremap |
|---|---|---|---|---|---|
| yuv444_128 | yuv444_128 | RGB_128 | BGR_128 | GRAY_128 | featuremap |
备注:
表格input_type_rt 指定input_type_rt 对应
yuv444_128 是yuv444数据
减去128结果,每个 数值 采用int8表示。 RGB_128 是RGB数据
减去128的 结果,每个 数值 采用int8表示。 BGR_128 是BGR数据
减去128的 结果,每个 数值 采用int8表示。 GRAY_128 是gray数据
减去128的 结果,每个 数值 采用int8表示。 featuremap 是
一个 四维张量 数据,每个 数值 采用float32表示。
模型
模型
模型original_float_model 一样,不过layout和original_float_model 输入
当
input_type_rt的取值 为 非 featuremap时,则输入 的 数据类型 均 使用INT8, 反之, 当 input_type_rt取值为 featuremap时,则输入 的 数据类型 则 为float32。 数据排布layout关系为:input_layout_train以及origin.onnx、calibrated_model.onnx、quanti.onnx输入的layout与原模型输入的layout一致。
注意:
如果input_type_rt为nv12时,对应quanti.onnx的
模型***.bin 模型,这个bin模型
转换结果解读
本makertbin 状态working_dir 产出makertbin 状态
  2023-12-06 11:13:08,337 INFO Convert to runtime bin file successfully!
  2023-12-06 11:13:08,337 INFO End Model Convert
相似makertbin 的makertbin 状态
  ======================================================================
  Node    ON   Subgraph  Type     Cosine Similarity  Threshold
  ...    ...     ...     ...       0.999936           127.000000
  ...    ...     ...     ...       0.999868           2.557209
  ...    ...     ...     ...       0.999268           2.133924
  ...    ...     ...     ...       0.996023           3.251645
  ...    ...     ...     ...       0.996656           4.495638
上面
Node、ON、Subgraph、Type与
hb_mapper checker工具的 解读 是 一致 的,请 参考 前 文 检查 结果 ;解读 Threshold是
每个 层次 的 校准 阈值,用于 异常 状态 下向 技术支持 反馈 信息,正常 状况 下 不 需要 关注; Cosine Similarity一列
反映 的 是Node列中 对应 算子 的 原始 浮点 模型 与 量化 模型 输出 结果 的 余弦 相似 度。
小
一般
转换working_dir 指定output_model_file_prefix 指定
***_original_float_model.onnx
***_optimized_float_model.onnx
***_calibrated_model.onnx
***_quantized_model.onnx
***.bin
转换
注意:
在
如果makertbin 工具prototxt 和 caffe_model 参数,模型
2021-04-21 14:45:34,085 ERROR Key 'model_parameters' error:
Missing keys: 'caffe_model', 'prototxt'
2021-04-21 14:45:34,085 ERROR yaml file parse failed. Please double check your input
2021-04-21 14:45:34,085 ERROR exception in command: makertbin
如果
转换产出物解读
上文
***_original_float_model.onnx
***_optimized_float_model.onnx
***_calibrated_model.onnx
***_quantized_model.onnx
***.bin
***_original_float_model.onnx的HzPreprocess, 可以
***_calibrated_model.onnx的
***_optimized_float_model.onnx的
***_quantized_model.onnx的
***.bin就是
注意:
通常
模型
6.3.2.5. 模型性能分析
本
开发机评测性能
使用 hb_perf 工具
hb_perf ***.bin
备注:
如果pack 后-p 参数,命令hb_perf -p ***.bin。
关于pack,请
命令hb_perf_result 文件夹,里边
  hb_perf_result/
  └── mobilenetv1_224x224_nv12
      ├── MOBILENET_subgraph_0.html
      ├── MOBILENET_subgraph_0.json
      ├── mobilenetv1_224x224_nv12
      ├── mobilenetv1_224x224_nv12.html
      ├── mobilenetv1_224x224_nv12.png
      └── temp.hbm
通过mobilenetv1_224x224_nv12.html 主
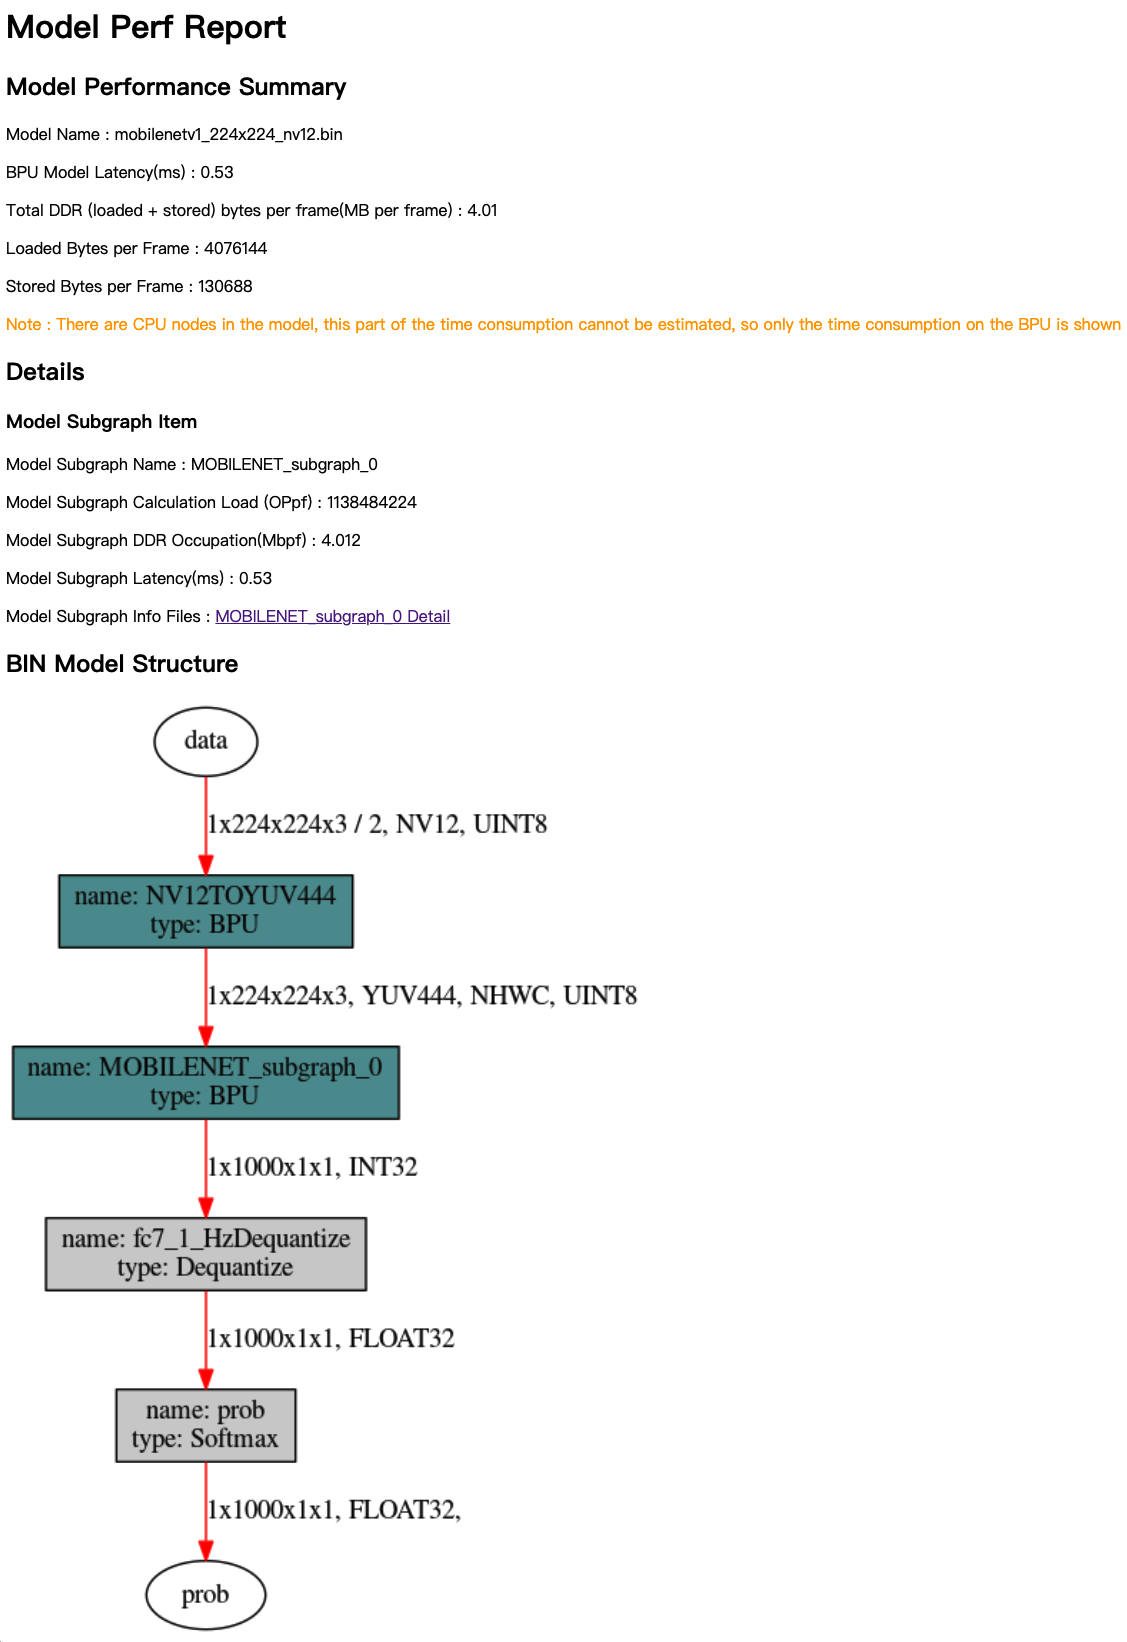
分析
Model Name——模型
名称。 Model Latency(ms)——模型
整体 单帧 计算 耗时(单位 为ms)。 Total DDR (loaded+stored) bytes per frame(MB per frame)——模型
整体BPU部分 数据 加载 和 存储 所 占用 的DDR总量(单位 为MB/frame)。 Loaded Bytes per Frame——模型
运行 每帧 读取数据 量。 Stored Bytes per Frame——模型
运行 每帧 存储 数据量。
BIN Model Structure部分
在
Details是mobilenetv1_224x224_nv12.html 主
Model Subgraph Name——子图
名称。 Model Subgraph Calculation Load (OPpf)——子图
的 单帧 计算 量。 Model Subgraph DDR Occupation(Mbpf)——子图
的 单帧 读写 数据量(单位 为MB)。 Model Subgraph Latency(ms)——子图
的 单帧 计算 耗时(单位 为ms)。
每个
注意:
参考debug ),从而debug 参数True 时才debug 参数
Layer Details提供
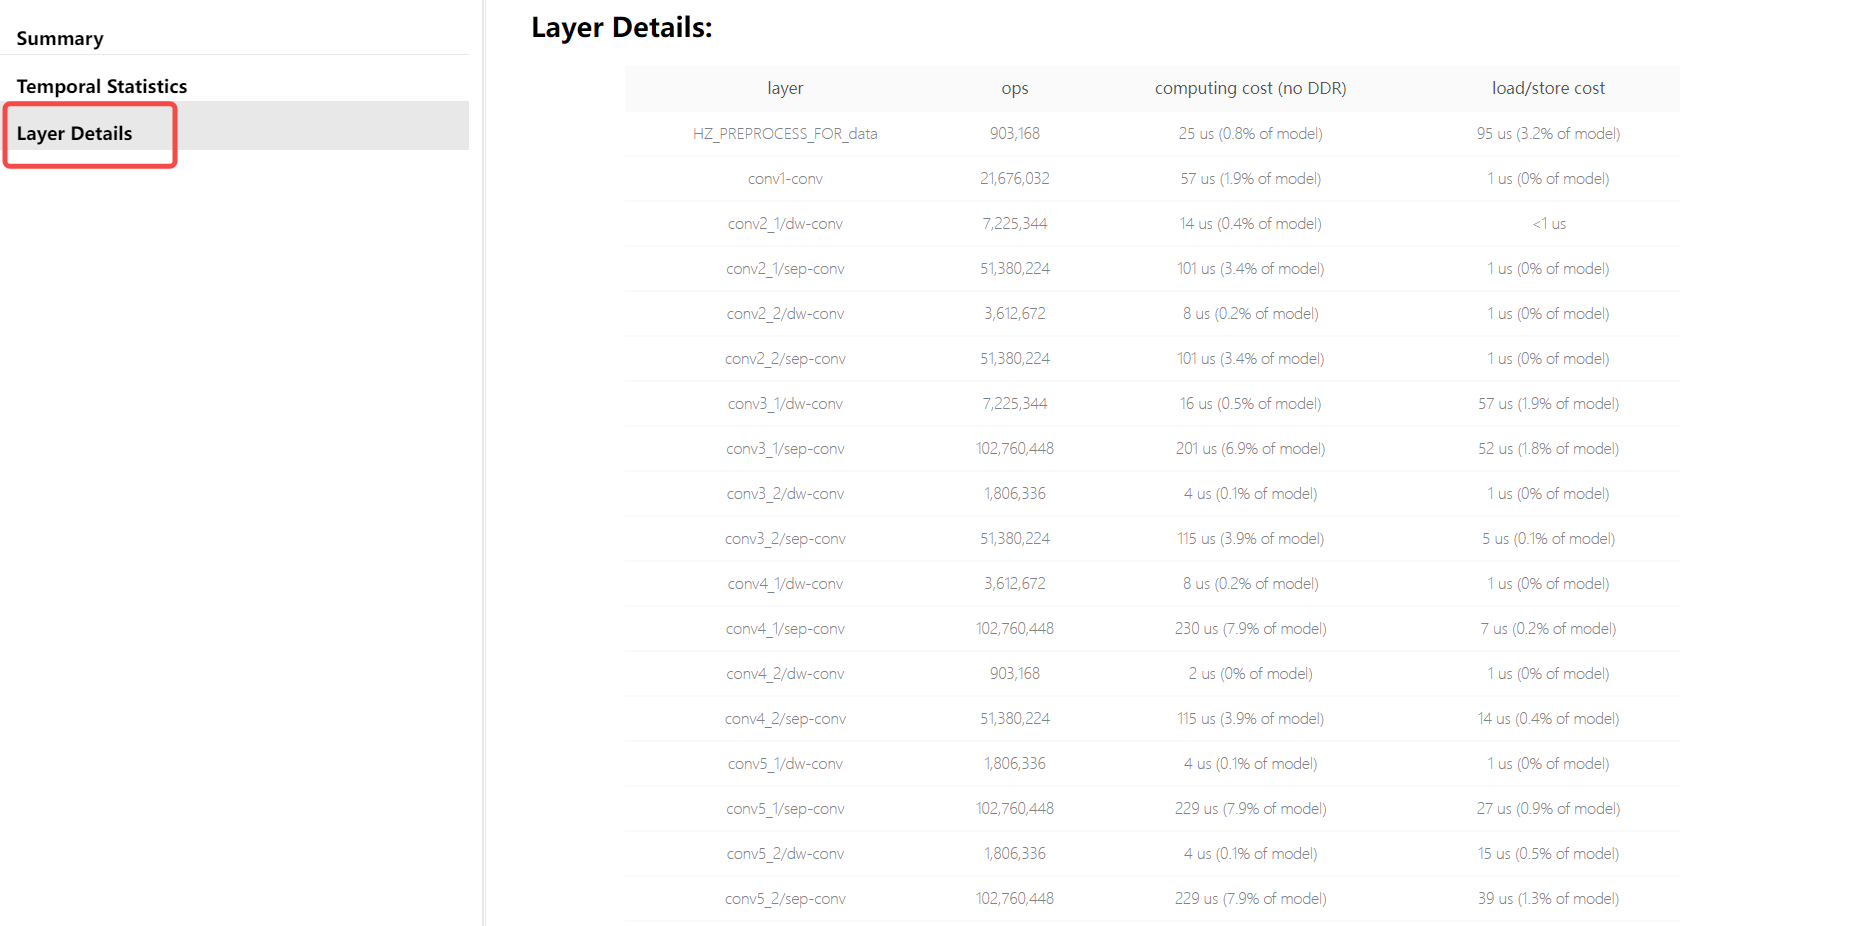
其中,每
layer:layer名。
ops:计算
量。 original output shape:原始
算子 输出shape。 aligned output shape:对齐
后 的 算子 输出shape。 computing cost (no DDR):计算
耗时。 load/store cost:数据
搬运 耗时。 active period of time:编译
后layer活跃 时间段(不 代表 该layer执行 时间,通常 为 多个layer交替/并行执行)。
注意:
hb_perf 工具
开发板实测性能
开发板hrt_model_exec perf 工具, 可
使用 hrt_model_exec perf 工具
确保您
已经 参考 系统 更新 章节 完成 了 开发板 系统 的 更新。 需要
将Ubuntu开发 机上 得到 的bin模型 拷贝到 开发板 上(建议 放在/userdata目录), 开发板 上 是 一个Linux系统,可以 通过 scp等Linux系统常用 方式 完成 这个 拷贝 过程。
hrt_model_exec perf 工具
./hrt_model_exec perf --model_file mobilenetv1_224x224_nv12.bin \
                      --model_name="" \
                      --core_id=0 \
                      --frame_count=200 \
                      --perf_time=0 \
                      --thread_num=1 \
                      --profile_path="."
hrt_model_exec perf参数
model_file:
需要
model_name:
需要model_file 只含
core_id:
默认值 0,运行
frame_count:
默认值 200,设置perf_time 为 0 时
perf_time:
默认值 0,单位
thread_num:
默认值 1,设置[1,8]。若
profile_path:
默认
下述
  Running condition:
    Thread number is: 4
    Frame count   is: 1000
    Program run time: 279.004000 ms
  Perf result:
    Frame totally latency is: 1084.040527 ms
    Average    latency    is: 1.084041 ms
    Frame      rate       is: 3584.178005 FPS
小Average latency 和 Frame rate,分别thread_num 的
控制台profile_path 参数
{
    "perf_result": {
      "FPS": 3718.384436330103,
      "average_latency": 1.0366870164871216
    },
    "running_condition": {
      "core_id": 0,
      "frame_count": 1000,
      "model_name": "mobilenetv1_224x224_nv12",
      "run_time": 268.934,
      "thread_num": 4
    }
  }
  ***
  {
    "processor_latency": {
      "BPU_inference_time_cost": {
        "avg_time": 0.8493590000000001,
        "max_time": 1.328,
        "min_time": 0.766
      },
      "CPU_inference_time_cost": {
        "avg_time": 0.074976,
        "max_time": 0.382,
        "min_time": 0.066
      }
    },
    "model_latency": {
      "BPU_MOBILENET_subgraph_0": {
        "avg_time": 0.8493590000000001,
        "max_time": 1.328,
        "min_time": 0.766
      },
      "Dequantize_fc7_1_HzDequantize": {
        "avg_time": 0.029727,
        "max_time": 0.124,
        "min_time": 0.028
      },
      "MOBILENET_subgraph_0_output_layout_convert": {
        "avg_time": 0.011379,
        "max_time": 0.077,
        "min_time": 0.008
      },
      "Preprocess": {
        "avg_time": 0.005363000000000001,
        "max_time": 0.039,
        "min_time": 0.003
      },
      "Softmax_prob": {
        "avg_time": 0.028507,
        "max_time": 0.142,
        "min_time": 0.027
      }
    },
    "task_latency": {
      "TaskPendingTime": {
        "avg_time": 0.021235,
        "max_time": 0.336,
        "min_time": 0.002
      },
      "TaskRunningTime": {
        "avg_time": 0.983558,
        "max_time": 2.208,
        "min_time": 0.904
      }
    }
  }
上述name 对应
Preprocess:表示对模型 输入 数据 进行padding和layout转换 操作,其 耗时 统计 在Preprocess中。 xxxx_input_layout_convert: 表示对BPU节点 的 输入 数据 进行padding和layout转换 的 操作,其 耗时 统计 在xxxx_input_layout_convert中。 xxxx_output_layout_convert: 表示对BPU节点 输出 数据 进行 去掉padding和layout转换 的 操作,其 耗时 统计 在xxxx_output_layout_convert中。 profiler分析是 模型 性能 调优中 经常 使用 的 操作,前 文 检查 结果 部分解读 提到 检查 阶段 不用 过于 关注CPU算子,此 阶段 可以 看到CPU算子 的 具体 耗时 情况,可以 根据 对应 算子 的 耗时 情况 来 进行 模型 性能 调优。
模型性能优化
通过
注意:
本
检查影响模型性能的yaml参数
在
layer_out_dump:指定模型 转换 过程 中 是否 输出 模型 的 中间 结果,一般 仅 用于 调试 功能。 如果 将 其 配置 为 True,则会 为 每个 卷积 算子 增加 一个 反 量化 输出 节点,它会 显著 的 降低 模型 上板 后 的 性能。 所以 在 性能 评测 时,务必 要 将 该 参数 配置 为 False。compile_mode:该参数 用于 选择 模型 编译 时 的 优化 方向 为 带宽 还是 时延,关注 性能 时请 配置 为 latency。optimize_level:该参数 用于 选择 编译器 的 优化 等级,实际 使用 中应 配置 为 O3获取最佳 性能。 debug:配置为 True将打开 编译器 的debug模式,能够 输出 性能 仿真 的 相关 信息,如帧 率、DDR 带宽 占用 等。 一般 用于 性能 评估 阶段,在 产品化 交付 时候,可 关闭 该 参数 减小 模型 大小,提高 模型 执行 效率。 max_time_per_fc:该参数 用于 控制 编译 后 的 模型 数据 指令 的function-call的 执行 时 长,从而 实现 模型 优先级 抢占 功能。 设置 此参数 更改 被 抢占 模型 的function-call执行 时长会 影响 该 模型 的 上板 性能。
处理CPU算子
根据 hrt_model_exec perf 工具
如果
备注:
修改input_channel 或 output_channel 超出范围
如果
CPU 算子
处于 模型 中部 对于CPU 算子
处于 模型 中部 的 情况,建议您 优先 尝试 参数 调整、算子 替换 或 修改 模型。 CPU算子
处于 模型 首 尾部 对于CPU算子
处于 模型 首 尾部 的 情况,请 参考 以下 示例,下面 以 量化/反 量化 节点 为例: 对于
与 模型 输入输出 相连 的 节点,可以 在yaml文件model_parameters配置 组(模型 参数 组)中 增加 remove_node_type参数,并重新 编译 模型。 remove_node_type: "Quantize; Dequantize"
或
使用hb_model_modifier 工具 对bin模型 进行 修改: hb_model_modifier x.bin -a Quantize -a Dequantize
对于
下图 这种 没有 与 输入输出 节点 相连 的 模型,则 需要 使用hb_model_modifier工具 判断 相连 节点 是否 支持 删除 后 按照 顺序 逐个 进行 删除。 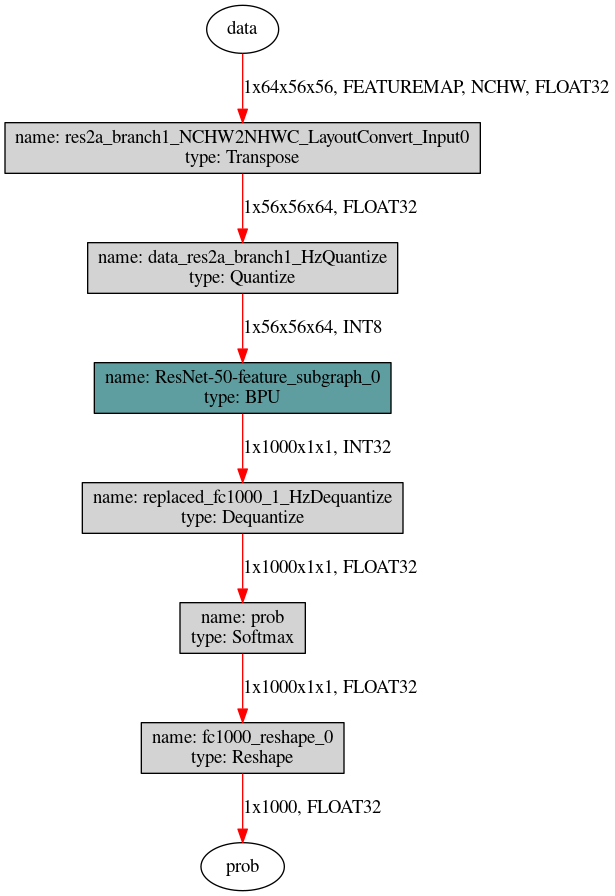
先
使用hb_perf工具 获取 模型 结构 图片,然后 使用 以下 两条 命令 可以 自上而下 移除Quantize节点, 对于Dequantize节点 自下而上 逐个 删除 即可,每 一步 可 删除 节点 的 名称 可以 通过 hb_model_modifier x.bin进行查看。 hb_model_modifier x.bin -r res2a_branch1_NCHW2NHWC_LayoutConvert_Input0 hb_model_modifier x_modified.bin -r data_res2a_branch1_HzQuantize
高性能模型设计建议
根据
本
Caffe中
的Softmax层 默认axis=1,而ArgMax层则 默认axis=0,算子 替换 时要 保持axis的 一致 Argmax的Channel需
小于 等于64,否则 只能 在CPU上 计算
6.3.2.6. 模型精度分析
基于1% 以内。
本
精度分析
前
***_original_float_model.onnx
***_optimized_float_model.onnx
***_calibrated_model.onnx
***_quantized_model.onnx
***.bin
虽然
建议您
注意:
示例
代码 不仅 适用 于quantized模型,对original和optimized模型 同样 适用,可以 根据 不同 模型 的 输入 类型 和layout要求 准备 数据 进行 模型 推理。 建议
参考 使用X5算法 工具链 模型 转换 horizon_model_convert_sample示例包中 的caffe、onnx等 示例 模型 的 精度 验证 方法: 04_inference.sh和postprocess.py。
import numpy as np
# 加载地瓜依赖库
from horizon_tc_ui import HB_ONNXRuntime

# 准备模型运行的输入
input_data = np.load("input.npy")
# 加载模型文件
sess = HB_ONNXRuntime(model_file = "***_quantized_model.onnx")
# 获取模型输入&输出节点信息
input_names = sess.input_names
output_names = sess.output_names
# 准备输入数据,这里我们假设此模型只有1个输入
input_info = {input_names[0]: input_data}
# 开始模型推理,推理的返回值是一个list,依次与output_names指定名称一一对应
output = sess.run(output_names, input_info)
此外, 输入input_type_train、 input_layout_train、 input_type_rt 和 input_layout_rt 四个
例如:使用ImageNet训练
图像
长宽 等 比scale,短边 缩 放到256。 center_crop方法获取224x224大小 图像。 按
通道 减mean。 数据
乘以scale系数。
使用X5算法input_type_train 设置 bgr、 input_layout_train 设置 NCHW、 input_type_rt 设置 bgr、
input_layout_rt 设置 NHWC。
根据转换your_custom_data_prepare 部分
  # 本示例使用skimage,如果是opencv会有所区别
  # 需要您特别注意的是,transformers中并没有体现减mean和乘scale的处理
  # mean和scale操作已经融合到了模型中,参考前文norm_type/mean_value/scale_value配置
def your_custom_data_prepare_sample(image_file):
    #skimage读取图片,已经是NHWC排布
    image = skimage.img_as_float(skimage.io.imread(image_file))
    # 长宽等比scale,短边缩放至256
    image = ShortSideResize(image, short_size=256)
    # CenterCrop获取224x224图像
    image = CenterCrop(image, crop_size=224)
    # skimage读取结果通道顺序为RGB,转换为bgr_128需要的BGR顺序
    image = RGB2BGR(image)
    # 如果原模型是 NCHW 输入(input_type_rt为nv12除外)
    if layout == "NCHW":
      image = HWC2CHW(image)
    # skimage读取数值范围为[0.0,1.0],调整为bgr需要的数值范围
    image = image * 255
    # bgr_128是bgr减去128
    image = image - 128
    #bgr_128使用int8
    image = image.astype(np.int8)

    return image
精度调优
基于
精度
有 较 明显 损失(损失 大于4%)。 这种 问题 往往 是 由于yaml配置 不当,校验 数据 集 不 均衡 等 导致 的,建议 根据 接下来 提供 的 建议 逐一 排查。
精度
损失 较 小(1.5%~3%)。 排除1导致 的 精度 问题 后,如果 仍然 出现 精度 有 小幅度 损失,往往 是 由于 模型 自身 的 敏感性 导致,建议 使用X5算法 工具链 提供 的 精度 调优 工具 进行 调优。
在
尝试1和2后,如果 精度 仍 无法 满足 预期,可以 尝试 使用 我们 提供 的 精度debug工具 进行 进一步 尝试。
整体
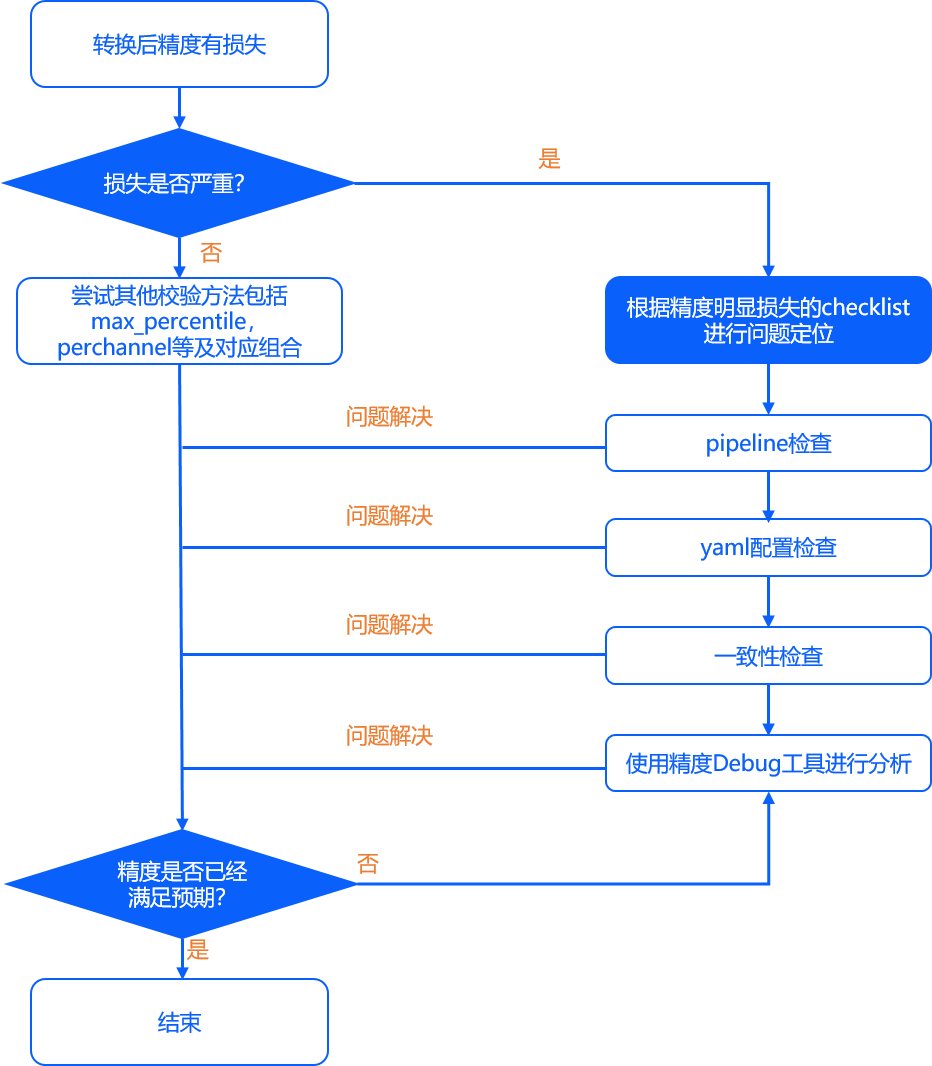
精度有明显损失(4%以上)
若
pipeline检查
pipeline是
模型
根据PTQ精度
input_type_rt和input_type_train该参数 用来 区分 转后 混合 异构 模型 与 原始 浮点 模型 需要 的 数据格式,需要 认真 检查 是否 符合 预期,尤其 是BGR和RGB通道 顺序 是否 正确。 norm_type、mean_value、scale_value等参数 是否 配置 正确。通过 转换 配置 可以 直接 在 模型 中 插入mean和scale操作 节点,需要 确认 是否 对 校验/测试 图片 进行 了 重复 的mean和scale操作 重复 预处理 。是 错误 的 易发 区
数据处理
未
正确 指定 read_mode:02_preprocess.sh中可 通过–read_mode参数 指定 读图 方式,支持 opencv及skimage。 此外preprocess.py中亦 是 通过imread_mode参数 设定 读图 方式,也 需要 做出 修改。使用 skimage的 图片 读取,得到 的 是 RGB通道顺序,取值 范围 为 0~1,数值类型 为 float; 而使用 opencv,得到 的 是 BGR通道顺序,取值 范围 为 0~255,数据类型为 uint8。校准
数据 集 的 存储 格式 设置 不 正确:目前X5采用 的 是 numpy.tofile来保存 校准 数据,这种 方式 不会 保存shape和 类型信息,在 加载 时 都 需要 手动 指定,需要 您 确保 这些 文件 的 序列化 和 反 序列化 过程 的 数据类型、数据 尺寸 和 数据 排布 等 信息 都 是 一致 的;如果input_type_train为 非featuremap格式,则会 通过 校准 数据 存放 路径 是否 包含 “f32” 来 判断 数据dtype,若 包含f32关键字,则 按float32解析 数据;反之 则 按uint8解析 数据。 transformer实现
方式 不 一致:我们 提供 了 一系列 常见 预处理 函数,存放 在 /horizon_model_convert_sample/01_common/python/data/transformer.py文件中,部分 预处理 操作 的 实现 方式 可能 会 有所区别,例如ResizeTransformer,采用 的 是opencv默认 插值 方式(linear), 若 为 其他 插值 方式 可 直接 修改transformer.py源码,确保 与 训练 时 预处理 代码 保持一致, 具体 使用 请 参考transformer使用 方法 章节内容。 建议您
在X5算法 工具链 使用 过程 中,依然 使用 原始 浮点 模型 训练 验证 阶段 依赖 的 数据处理 库。 对于 鲁棒性 较差 的 模型,不同 库 实现 的 功能resize、crop等 典型 功能 都 可能 引起 扰动,进而 影响 模型 精度。 校验
图片集 是否 合理 设置。校准 图片集 数量 应该 在 一百张左右,同时最好 可以 覆盖 到 数据分布 的 各种 场合,例如 在 多任务 或 多 分类 时,校验 图片集 可以 覆盖 到 各个 预测 分支 或者 各个 类别。 同时 避免 偏离 数据分布 的 异常 图片(过 曝光 等)。 使用
***_original_float_model.onnx再验证 一遍 精度,正常 情况 下,这个 模型 的 精度 应该 是 与 原始 浮点 模型 精度 保持 小数点后三到五位对齐。 如果验证 发现 不 满足 这种 对齐 程度,则 表明 您 的 数据处理 需要 再 仔细检查。
较小精度损失提升(1.5%~3%)
一般calibration_type 配置default。default为“Select kl method.” 的
如果
开启per-channel还会 打印: Perchannel quantization is enabled。如果
开启 非对称asymmetric量化 还会 打印: Asymmetric quantization is enabled。
若
调整
在
配置 中 手动 指定 calibration_type,可以先 选择 mix,如果最终 精度 仍 不 符合 预期,再 尝试 kl/max;在
calibration_type设定为 max时,同时配置 max_percentile为不同 的 分 位数(取值 范围 是0.5-1之间),我们 推荐 您 优先 尝试 0.99999、0.99995、0.9999、0.9995、0.999,通过这 几个 配置 观察 模型 精度 的 变化趋势,最终 找到 一个 最佳 的 分 位数; 在
上方 尝试 的 基础 上,选择 余弦 相似 度 最高 的 方案,在 配置 转换 中 尝试 启用 per_channel;yaml中
optimization参数还 提供 了 asymmetric与bias_correction选项用于 精度 调试,实验 发现 这 两个 参数 在 部分 场景 中 可以 提升 量化 精度,可 进行 进一步 尝试。
调准
可以
尝试 适当 增加或减少数据数量(通常 来说 检测 场景 相 较 于 分类 场景 需要 的 校准 数据 要少;此外 可以 观察 模型 输出 的 漏检 情况,适当 增加 对应 场景 的 校准 数据); 观察
模型 输出 的 漏检 情况,适当 增加 对应 场景 的 校准 数据; 不要
使用 纯黑 纯白 等 异常 数据,尽量减少 使用 无 目标 的 背景图 作为 校准 数据;尽可能 全面 的 覆盖 典型 任务 场景,使得 校准 数据 集 的 分布 与 训练 集 近似。
将
一般
我们 仅会 尝试 将 模型 输出 层 的 1~2个算子 回退 至 CPU,太多 的CPU算子 会 较大 程度 影响 模型 最终 性能,判断 依据 可 通过观察 模型 的 余弦相似度若将 某些 中间 节点run_on_cpu,发现 精度 没有 提升,这是 正常 现象,因为 反复 重量 化 可能 还会 带来 更大 的 精度 损失,因此 通常 只 建议 将 尾部 节点 回退 至cpu); 指定
算子 运行 在CPU上 请 通过yaml文件 中 的 node_info参数。
精度Debug工具
在
若
在X5 产品,目前int16配置说明 参数
算法
模型
中 的 一部分 节点 对 量化 比较 敏感 会 引入 较大 误差,即 敏感 节点 量化 问题。 模型
中 各个 节点 的 误差 累积 导致 模型 整体 出现 较大 的 校准 误差,主要 包含:权重 量化 导致 的 误差 累积、激活 量化 导致 的 误差 累积 以及 全量 量化 导致 的 误差 累积。
针对
精度debug工具
获取
节点 量化 敏感度。 获取
模型 累积 误差 曲线。 获取
指定 节点 的 数据分布。 获取
指定 节点 输入 数据通道 间 数据分布 箱 线图 等。
使用方法说明
使用
在yaml中
的 模型 参数 配置组(model_parameters) 参数 debug_mode="dump_calibration_data",保存校准 数据。 导入debug模块,加载
校准 模型 和 数据。 通过
精度debug工具 提供 的API或 命令行,对 精度 损失 明显 的 模型 进行 分析。
注意:
对于bayes-e 架构
整体
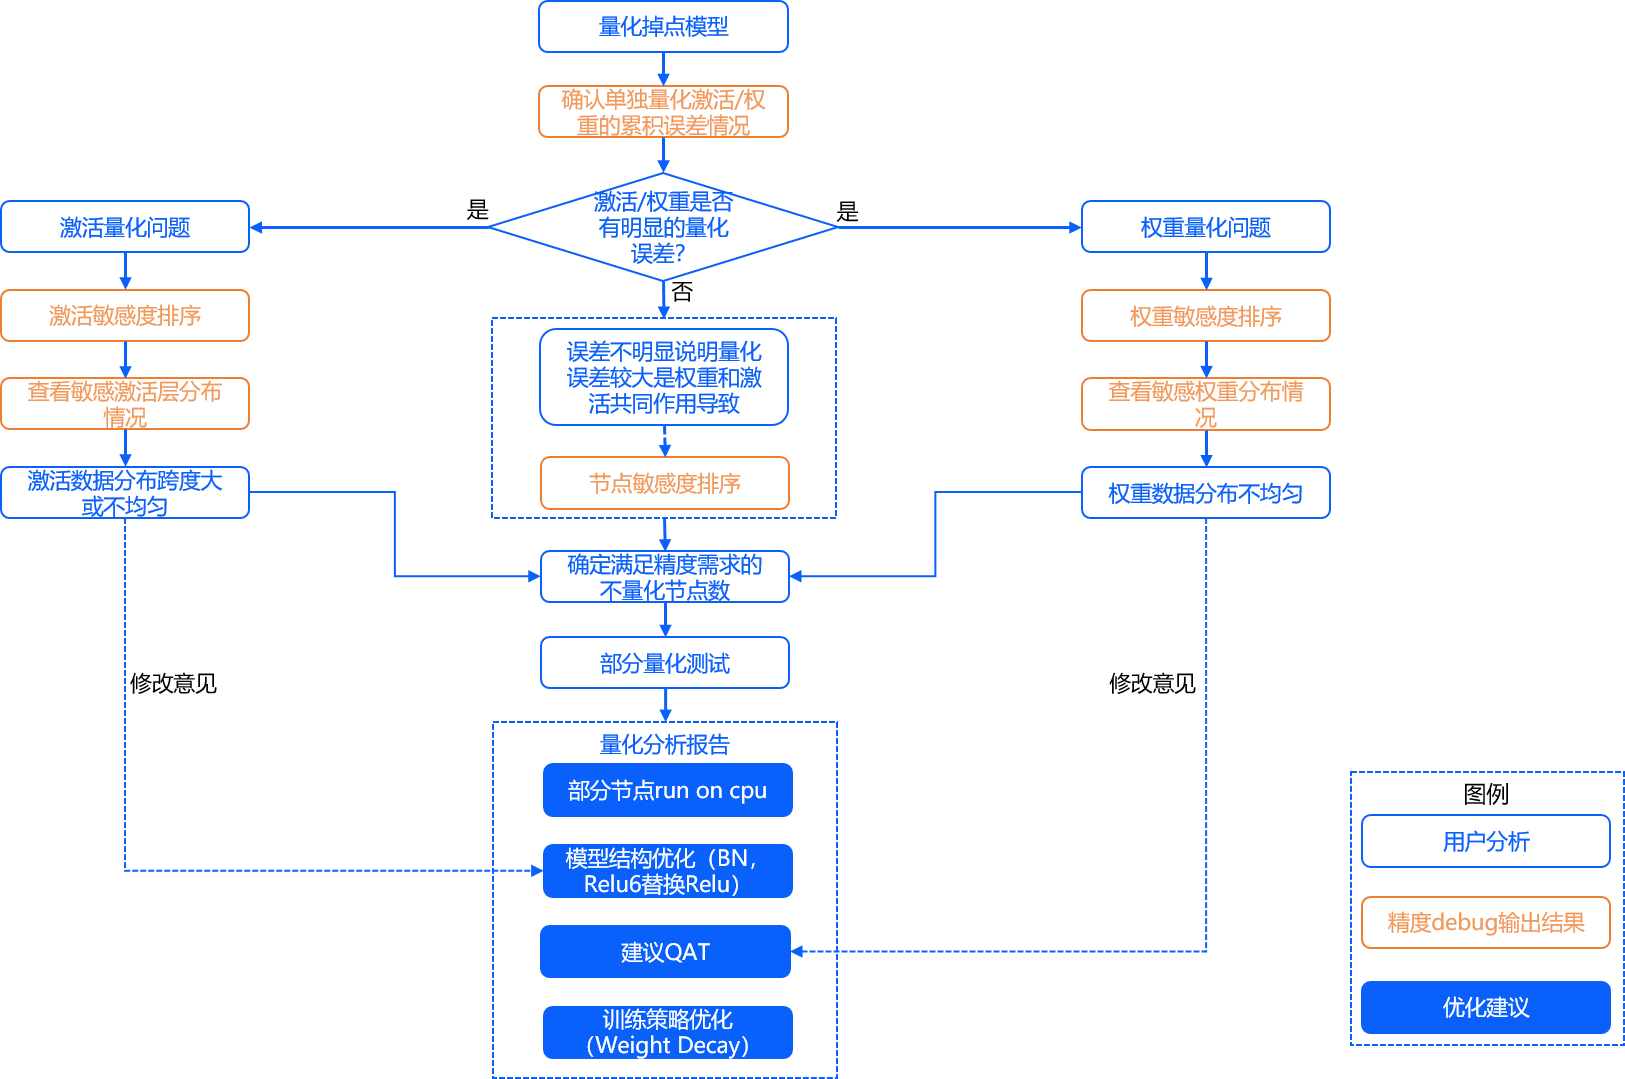
确认
单独 量化 激活/权重 的 累积 误差 情况,请 阅读 plot_acc_error 章节 内容; 激活
敏感度 排序,请 阅读 get_sensitivity_of_nodes 章节 内容; 权重
敏感度 排序,请 阅读 get_sensitivity_of_nodes 章节 内容; 节点
敏感度 排序,请 阅读 get_sensitivity_of_nodes 章节 内容; 查看
敏感 激活 层 分布 情况,请 阅读 plot_distribution 章节 内容,以及 get_channelwise_data_distribution 章节 内容; 查看
敏感 权重 分布 情况,请 阅读 plot_distribution 章节 内容,以及 get_channelwise_data_distribution 章节 内容; 敏感
节点 单独 量化 及 部份 量化 测试,请 阅读 sensitivity_analysis 章节 内容;
校准
首先debug_mode="dump_calibration_data" ,以
校准
数据(calibration_data):在 校准 阶段,模型 通过 对 这些 数据 进行 前向 推理 来 获取 每个 被 量化 节点 的 量化 参数,包括:缩放 因子(scale)和 阈值(threshold)。 校准
模型(calibrated_model.onnx):将 在 校准 阶段 计算 得到 的 每个 被 量化 节点 的 量化 参数 保存 在 校准 节点 中,从而 得到 校准 模型。
注意:
此处
02_preprocess.sh 得到
注意:
校准
校准
激活
权重
除却
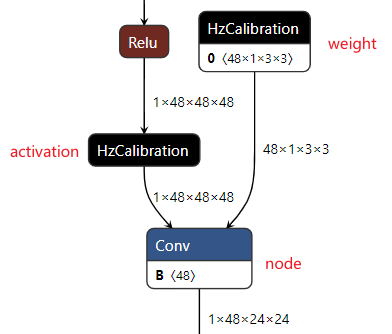
calibration_data的
  |--calibration_data :校准数据
  |----input.1 :文件夹名为模型的输入节点并保存对应的输入数据
  |--------0.npy
  |--------1.npy
  |-------- ...
  |----input.2 :对于多输入模型将保存多个文件夹
  |--------0.npy
  |--------1.npy
  |-------- ...
精度debug模块
导入 与 使用
接下来get_sensitivity_of_nodes 接口get_sensitivity_of_nodes 的
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg
# 导入log日志模块
import logging

# 若verbose=True时,需要先设置log level为INFO
logging.getLogger().setLevel(logging.INFO)
# 获取节点量化敏感度
node_message = dbg.get_sensitivity_of_nodes(
        model_or_file='./calibrated_model.onnx',
        metrics=['cosine-similarity', 'mse'],
        calibrated_data='./calibration_data/',
        output_node=None,
        node_type='node',
        data_num=None,
        verbose=True,
        interested_nodes=None)
分析
结果 展示
下方verbose=True 时
  =================node sensitivity=================
  node                  cosine-similarity  mse
  ---------------------------------------------------
  Conv_60               0.77795            68.02103
  Conv_48               0.78428            64.36318
  Conv_82               0.80394            61.09268
  Conv_94               0.80499            65.05224
  Conv_42               0.83787            49.4949
  Conv_88               0.84614            49.81132
  Conv_54               0.86602            41.69972
  Conv_71               0.87148            39.96296
  Conv_65               0.87495            40.45997
  Conv_25               0.89214            34.30351
  Conv_20               0.89829            32.35053
  Conv_77               0.89916            31.9907
  Conv_14               0.90058            32.40179
  Conv_9                0.90107            34.08191
  Conv_37               0.91162            28.21194
  Conv_31               0.91637            28.79291
除此之外,该API会以
  Out:
  {'Conv_60': {'cosine-similarity': 0.77795, 'mse': 68.02103},
   'Conv_48': {'cosine-similarity': 0.78428, 'mse': 64.36318},
   'Conv_82': {'cosine-similarity': 0.80394, 'mse': 61.09268},
   'Conv_94': {'cosine-similarity': 0.80499, 'mse': 65.05224},
   'Conv_42': {'cosine-similarity': 0.83787, 'mse': 49.4949},
   'Conv_88': {'cosine-similarity': 0.84614, 'mse': 49.81132},
   'Conv_54': {'cosine-similarity': 0.86602, 'mse': 41.69972},
   'Conv_71': {'cosine-similarity': 0.87148, 'mse': 39.96296},
   'Conv_65': {'cosine-similarity': 0.87495, 'mse': 40.45997},
   'Conv_25': {'cosine-similarity': 0.89214, 'mse': 34.30351},
   'Conv_20': {'cosine-similarity': 0.89829, 'mse': 32.35053},
   'Conv_77': {'cosine-similarity': 0.89916, 'mse': 31.9907},
   'Conv_14': {'cosine-similarity': 0.90058, 'mse': 32.40179},
   'Conv_9': {'cosine-similarity': 0.90107, 'mse': 34.08191},
   'Conv_37': {'cosine-similarity': 0.91162, 'mse': 28.21194},
   'Conv_31': {'cosine-similarity': 0.91637, 'mse': 28.79291}}
更
小
精度debug工具hmct-debugger -h/--help 查看
功能说明
get_sensitivity_of_nodes
功能:获取
命令行
hmct-debugger get-sensitivity-of-nodes MODEL_OR_FILE CALIBRATION_DATA --other options
可hmct-debugger get-sensitivity-of-nodes -h/--help 查看
参数
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
model_or_file |
参数 参数 |
取值 默认 |
必选 |
metrics 或 - m |
参数 参数 |
取值'cosine-similarity' , 'mse' , 'mre' , 'sqnr' , 'chebyshev' 。默认 'cosine-similarity'。 |
可 |
calibrated_data |
参数 参数 |
取值 默认 |
必选 |
output_node 或 -o |
参数 参数 |
取值 默认 |
可 |
node_type 或 -n |
参数 参数 |
取值'node' , 'weight' , 'activation'。默认 'node'。 |
可 |
data_num 或 -d |
参数 参数 |
取值 默认 |
可 |
verbose 或 -v |
参数 参数 |
取值True 、 False。默认 False。 |
可 |
interested_nodes 或 -i |
参数 参数 |
取值 默认 |
可 |
函数
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg
# 导入log日志模块
import logging

# 若verbose=True时,需要先设置log level为INFO
logging.getLogger().setLevel(logging.INFO)
# 获取节点量化敏感度
node_message = dbg.get_sensitivity_of_nodes(
        model_or_file='./calibrated_model.onnx',
        metrics=['cosine-similarity', 'mse'],
        calibrated_data='./calibration_data/',
        output_node=None,
        node_type='node',
        data_num=None,
        verbose=True,
        interested_nodes=None)
命令行
hmct-debugger get-sensitivity-of-nodes calibrated_model.onnx calibration_data -m ['cosine-similarity','mse'] -v True
分析
描述:首先
verbose=True时,打印
  =================node sensitivity=================
  node                  cosine-similarity  mse
  ---------------------------------------------------
  Conv_60               0.77795            68.02103
  Conv_48               0.78428            64.36318
  Conv_82               0.80394            61.09268
  Conv_94               0.80499            65.05224
  Conv_42               0.83787            49.4949
  Conv_88               0.84614            49.81132
  Conv_54               0.86602            41.69972
  Conv_71               0.87148            39.96296
  Conv_65               0.87495            40.45997
  Conv_25               0.89214            34.30351
  Conv_20               0.89829            32.35053
  Conv_77               0.89916            31.9907
  Conv_14               0.90058            32.40179
  Conv_9                0.90107            34.08191
  Conv_37               0.91162            28.21194
  Conv_31               0.91637            28.79291
其中:
node:节点
名。 cosine-similarity、mse:各个
节点 的 量化 敏感度 数值。
verbose=True且node_type=’weight’时,打印
   ====================================node sensitivity====================================
   weight                                              node     cosine-similarity  mse
   -----------------------------------------------------------------------------------------
   471_HzCalibration                                   Conv_2   0.99978            0.07519
   480_HzCalibration                                   Conv_7   0.99986            0.04823
   609_HzCalibration                                   Conv_88  0.99997            0.01145
   573_HzCalibration                                   Conv_65  0.99997            0.00984
   474_HzCalibration                                   Conv_4   0.99997            0.00963
   468_HzCalibration                                   Conv_0   0.99997            0.0091
   612_HzCalibration                                   Conv_90  0.99997            0.00871
   585_HzCalibration                                   Conv_73  0.99997            0.0095
   483_HzCalibration                                   Conv_9   0.99998            0.00818
   600_HzCalibration                                   Conv_82  0.99998            0.00717
   582_HzCalibration                                   Conv_71  0.99998            0.00659
   603_HzCalibration                                   Conv_84  0.99998            0.00614
   591_HzCalibration                                   Conv_77  0.99998            0.00558
   489_HzCalibration                                   Conv_12  0.99998            0.00515
   564_HzCalibration                                   Conv_60  0.99999            0.00495
   618_HzCalibration                                   Conv_94  0.99999            0.00498
   543_HzCalibration                                   Conv_46  0.99999            0.00502
   552_HzCalibration                                   Conv_52  0.99999            0.00501
   594_HzCalibration                                   Conv_78  0.99999            0.00451
   555_HzCalibration                                   Conv_54  0.99999            0.00452
   ...99classifier.1.weight_conv_weight_HzCalibration  Gemm_99  0.99999            0.00359
   558_HzCalibration                                   Conv_56  0.99999            0.00369
其中:
weight:权重
校准 节点 名。 node:权重
校准 节点 对应 的 普通 节点 名,即 权重 校准 节点 的 输出 为 其 输入。 cosine-similarity、mse:各个
节点 的 量化 敏感度 数值。
verbose=True且node_type=’activation’时,打印
   ===================================node sensitivity===================================
   activation          node                  threshold  bit  cosine-similarity  mse
   ---------------------------------------------------------------------------------------
   406_HzCalibration   Conv_60               0.91501    8    0.77851            67.82422
   388_HzCalibration   Conv_48               0.55422    8    0.78501            64.16379
   440_HzCalibration   Conv_82               2.01577    8    0.8041             61.0322
   458_HzCalibration   Conv_94               0.51507    8    0.80466            65.14515
   379_HzCalibration   Conv_42               0.53759    8    0.83837            49.35648
   449_HzCalibration   Conv_88               2.34071    8    0.84447            50.29965
   397_HzCalibration   Conv_54               0.81528    8    0.86499            41.99234
   423_HzCalibration   Conv_71               0.84753    8    0.87104            40.09385
   414_HzCalibration   Conv_65               0.80155    8    0.87443            40.63319
   353_HzCalibration   Conv_25               0.67858    8    0.89199            34.34844
   345_HzCalibration   Conv_20               1.06324    8    0.8984             32.31664
   432_HzCalibration   Conv_77               2.54515    16   0.89895            32.0417
   336_HzCalibration   Conv_14               1.01407    8    0.90091            32.30325
   328_HzCalibration   Conv_9                1.61622    8    0.90163            33.78012
   371_HzCalibration   Conv_37               0.91038    8    0.91277            27.84864
   362_HzCalibration   Conv_31               0.65606    8    0.91683            28.65791
   403_HzCalibration   Conv_58               0.95119    8    0.93365            21.32314
   391_HzCalibration   Conv_50;Add_55        2.92598    8    0.93984            19.72109
   382_HzCalibration   Conv_44;Add_49        2.75416    8    0.95122            17.74137
   417_HzCalibration   Conv_67;Add_72        2.85463    8    0.95139            15.81864
其中:
activation:激活
校准 节点 名。 node:在
模型 结构 中 在 激活 校准 节点 后 的 普通 节点,即 激活 校准 节点 的 输出 为 其 输入。 threshold:校准
阈值,若有 多个 阈值 则 取 最大值。 bit:量化
比特。 cosine-similarity、mse:各个
节点 的 量化 敏感度 数值。
API返回值:
API返回值
  Out:
  {'Conv_60': {'cosine-similarity': 0.77795, 'mse': 68.02103},
   'Conv_48': {'cosine-similarity': 0.78428, 'mse': 64.36318},
   'Conv_82': {'cosine-similarity': 0.80394, 'mse': 61.09268},
   'Conv_94': {'cosine-similarity': 0.80499, 'mse': 65.05224},
   'Conv_42': {'cosine-similarity': 0.83787, 'mse': 49.4949},
   'Conv_88': {'cosine-similarity': 0.84614, 'mse': 49.81132},
   'Conv_54': {'cosine-similarity': 0.86602, 'mse': 41.69972},
   'Conv_71': {'cosine-similarity': 0.87148, 'mse': 39.96296},
   'Conv_65': {'cosine-similarity': 0.87495, 'mse': 40.45997},
   'Conv_25': {'cosine-similarity': 0.89214, 'mse': 34.30351},
   'Conv_20': {'cosine-similarity': 0.89829, 'mse': 32.35053},
   'Conv_77': {'cosine-similarity': 0.89916, 'mse': 31.9907},
   'Conv_14': {'cosine-similarity': 0.90058, 'mse': 32.40179},
   'Conv_9': {'cosine-similarity': 0.90107, 'mse': 34.08191},
   'Conv_37': {'cosine-similarity': 0.91162, 'mse': 28.21194},
   'Conv_31': {'cosine-similarity': 0.91637, 'mse': 28.79291}}
plot_acc_error
功能:只
命令行
hmct-debugger plot-acc-error MODEL_OR_FILE CALIBRATION_DATA --other options
可hmct-debugger plot-acc-error -h/--help 查看
参数
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
save_dir 或 -s |
参数 参数 |
取值 默认 |
可 |
calibrated_data |
参数 参数 |
取值 默认 |
必选 |
model_or_file |
参数 参数 |
取值 默认 |
必选 |
quantize_node 或 -q |
参数 参数 通过 例如: - quantize_node=['Conv_2','Conv_9']:分别 - quantize_node=[['Conv_2'],['Conv_9','Conv_2']]:只 - quantize_node 包含 当: - quantize_node = ['weight']:只 - quantize_node = ['activation']:只 - quantize_node = ['weight','activation']:权重 注:quantize_node和non_quantize_node不可 |
取值 默认 |
可 |
non_quantize_node 或 -nq |
参数 参数 通过 例如: - non_quantize_node=['Conv_2','Conv_9']:分别 - non_quantize_node=[['Conv_2'],['Conv_9','Conv_2']]:只 注:quantize_node和non_quantize_node不可 |
取值 默认 |
可 |
metric 或 -m |
参数 参数 |
取值'cosine-similarity' , 'mse' , 'mre' , 'sqnr' , 'chebyshev'默认 'cosine-similarity'。 |
可 |
average_mode 或 -a |
参数 参数 |
取值True 、 False。默认 False。 |
可 |
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.plot_acc_error(
        save_dir: str,
        calibrated_data: str or CalibrationDataSet,
        model_or_file: ModelProto or str,
        quantize_node: List or str,
        non_quantize_node: List or str,
        metric: str = 'cosine-similarity',
        average_mode: bool = False)
分析
1.指定
指定
单 节点 量化
配置
API函数
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.plot_acc_error(
        save_dir='./',
        calibrated_data='./calibration_data/',
        model_or_file='./calibrated_model.onnx',
        quantize_node=['Conv_2', 'Conv_90'],
        metric='cosine-similarity',
        average_mode=False)
命令行
hmct-debugger plot-acc-error calibrated_model.onnx calibrated_data -q ['Conv_2','Conv_90']
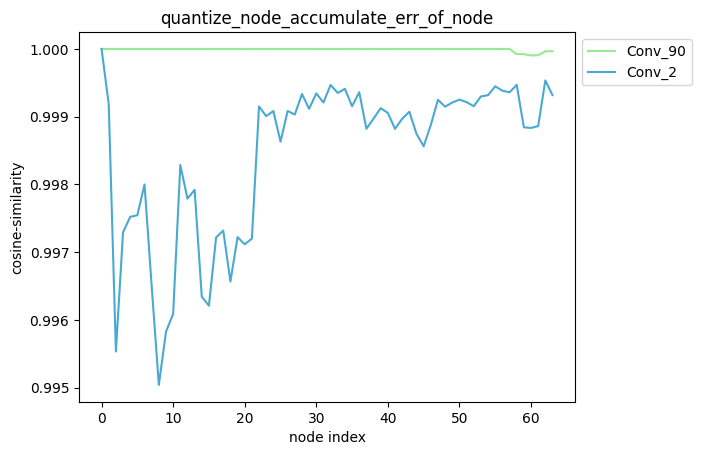
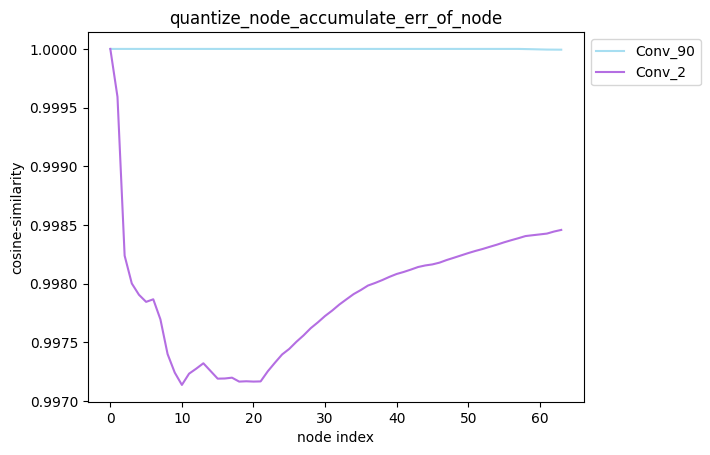
描述:当quantize_node为单
average_mode = False时:
average_mode = True时:
注意:
average_mode
average_mode默认
具体
average_mode=False时,accumulate_error=[1.0, 0.9, 0.9, 0.8]。
而
指定
多个 节点 量化
配置
API使用
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.plot_acc_error(
        save_dir='./',
        calibrated_data='./calibration_data/',
        model_or_file='./calibrated_model.onnx',
        quantize_node=[['Conv_2'], ['Conv_2', 'Conv_90']],
        metric='cosine-similarity',
        average_mode=False)
命令行
hmct-debugger plot-acc-error calibrated_model.onnx calibration_data -q [['Conv_2'],['Conv_2','Conv_90']]
描述:当quantize_node为
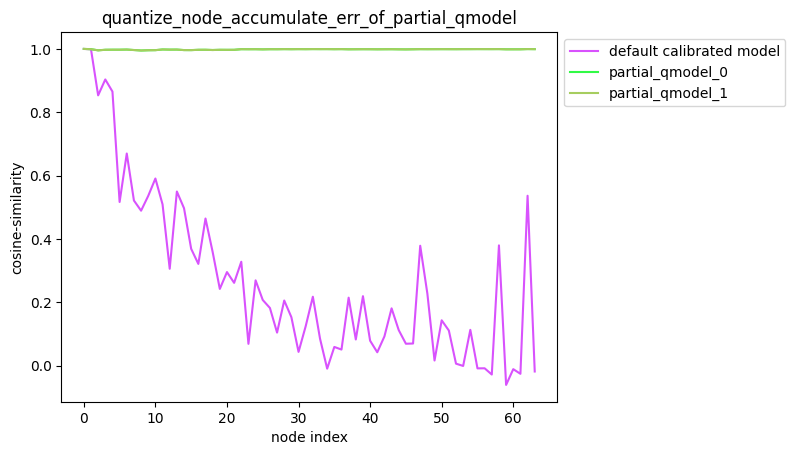
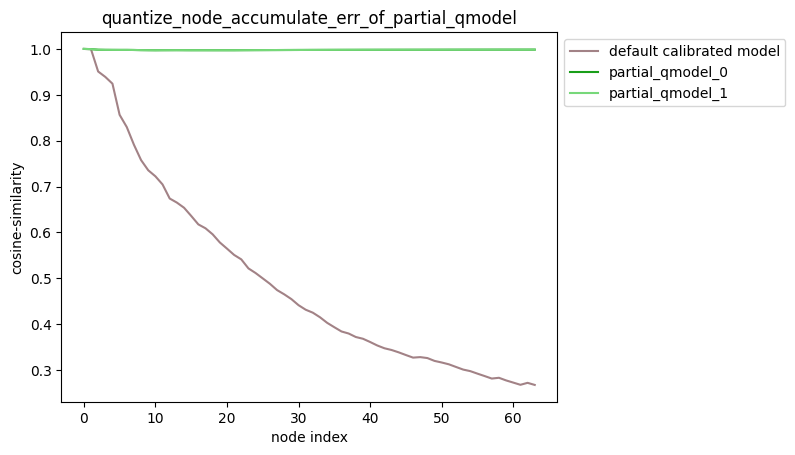
partial_qmodel_0:只
量化Conv_2节点,其余 节点 不 量化; partial_qmodel_1:只
量化Conv_2和Conv_90节点,其余 节点 不 量化。
average_mode=False时:
average_mode=True时:
2.解除
指定
单 节点 不 量化
配置
API使用
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.plot_acc_error(
        save_dir='./',
        calibrated_data='./calibration_data/',
        model_or_file='./calibrated_model.onnx',
        non_quantize_node=['Conv_2', 'Conv_90'],
        metric='cosine-similarity',
        average_mode=True)
命令行
hmct-debugger plot-acc-error calibrated_model.onnx calibration_data -nq ['Conv_2','Conv_90'] -a True
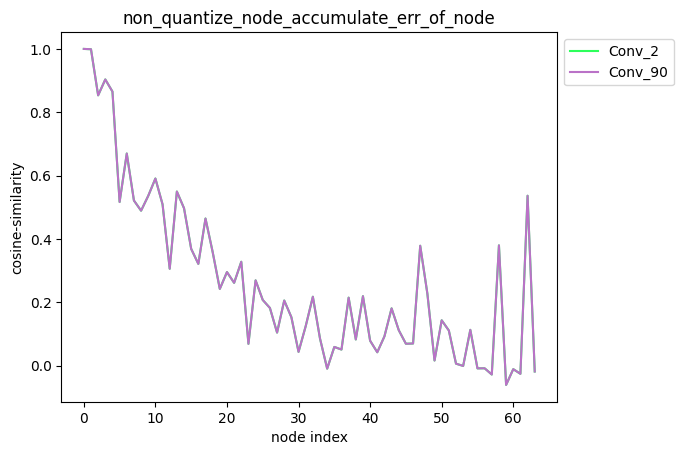
描述:当non_quantize_node为单
average_mode = False时:
average_mode = True时:
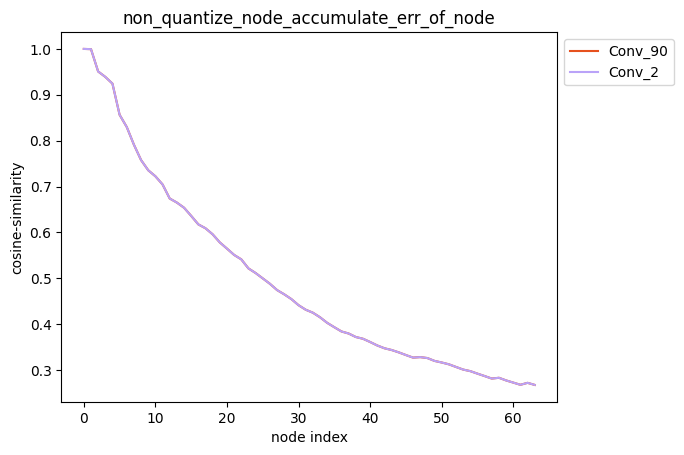
指定
多个 节点 不 量化
配置
API使用
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.plot_acc_error(
        save_dir='./',
        calibrated_data='./calibration_data/',
        model_or_file='./calibrated_model.onnx',
        non_quantize_node=[['Conv_2'], ['Conv_2', 'Conv_90']],
        metric='cosine-similarity',
        average_mode=False)
命令行
hmct-debugger plot-acc-error calibrated_model.onnx calibration_data -nq [['Conv_2'],['Conv_2','Conv_90']]
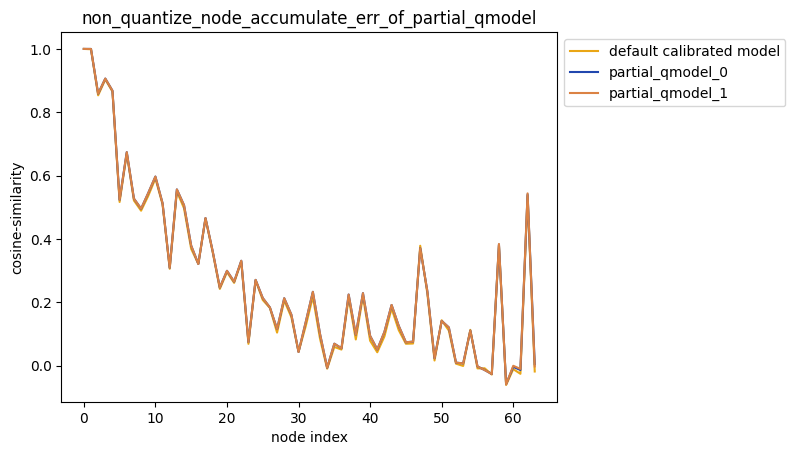
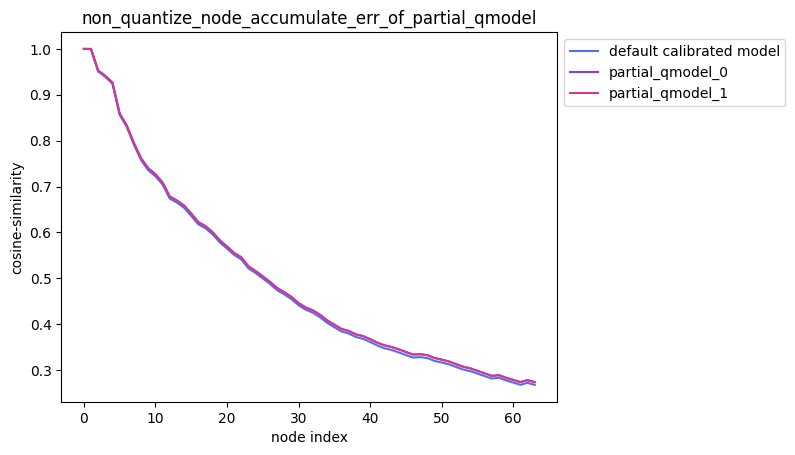
描述:当non_quantize_node为
partial_qmodel_0:不
量化Conv_2节点,其余 节点 量化; partial_qmodel_1:不
量化Conv_2和Conv_90节点,其余 节点 量化。
average_mode = False时:
average_mode = True时:
测试
测试
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

# 首先使用量化敏感度排序函数获取模型中节点的量化敏感度排序
node_message = dbg.get_sensitivity_of_nodes(
        model_or_file='./calibrated_model.onnx',
        metrics='cosine-similarity',
        calibrated_data='./calibration_data/',
        output_node=None,
        node_type='node',
        verbose=False,
        interested_nodes=None)

# node_message为字典类型,其key值为节点名称
nodes = list(node_message.keys())

# 通过nodes来指定不量化节点,可以方便使用
dbg.plot_acc_error(
        save_dir='./',
        calibrated_data='./calibration_data/',
        model_or_file='./calibrated_model.onnx',
        non_quantize_node=[nodes[:1],nodes[:2]],
        metric='cosine-similarity',
        average_mode=True)
3.激活
配置
API使用
import horizon_nn.quantizer.debugger as dbg

dbg.plot_acc_error(
        save_dir='./',
        calibrated_data='./calibration_data/',
        model_or_file='./calibrated_model.onnx',
        quantize_node=['weight','activation'],
        metric='cosine-similarity',
        average_mode=False)
命令行
hmct-debugger plot_acc_error calibrated_model.onnx calibration_data -q ['weight','activation']
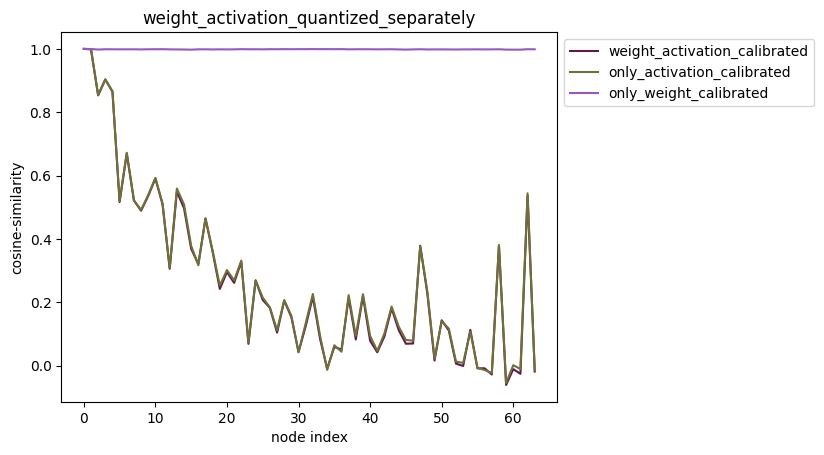
描述:quantize_node也
quantize_node = [’weight’]:只
量化 权重,不 量化 激活。 quantize_node = [’activation’]:只
量化 激活,不 量化 权重。 quantize_node = [’weight’, ‘activation’]:权重
和 激活 分别 量化。
plot_distribution
功能:选取
命令行
hmct-debugger plot-distribution MODEL_OR_FILE CALIBRATION_DATA --other options
可hmct-debugger plot-distribution -h/--help 查看
参数
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
save_dir 或 -s |
参数 参数 |
取值 默认 |
可 |
model_or_file |
参数 参数 |
取值 默认 |
必选 |
calibrated_data |
参数 参数 |
取值 默认 |
必选 |
nodes_list 或 -n |
参数 参数 若nodes_list中 - 权重 - 激活 - 普通 注:nodes_list为 list 类型,可 |
取值 默认 |
必选 |
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.plot_distribution(
        save_dir: str,
        model_or_file: ModelProto or str,
        calibrated_data: str or CalibrationDataSet,
        nodes_list: List[str] or str)
分析
API使用
  # 导入debug模块
  import horizon_nn.quantizer.debugger as dbg

  dbg.plot_distribution(
          save_dir='./',
          model_or_file='./calibrated_model.onnx',
          calibrated_data='./calibration_data',
          nodes_list=['317_HzCalibration', # 激活节点
                      '471_HzCalibration', # 权重节点
                      'Conv_2']) # 普通节点
命令行
hmct-debugger plot-distribution calibrated_model.onnx calibration_data -n ['317_HzCalibration','471_HzCalibration','Conv_2']
node_output:
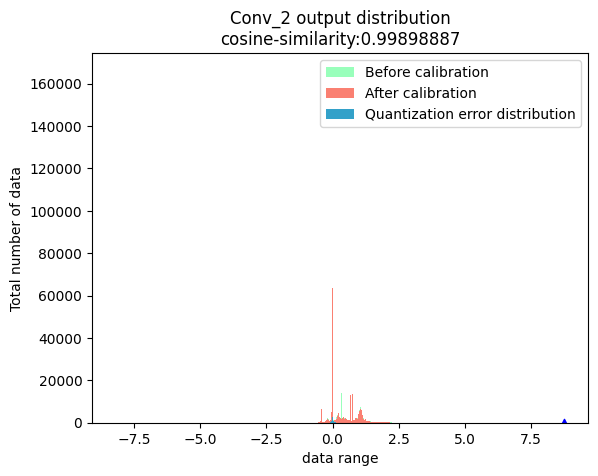
weight:
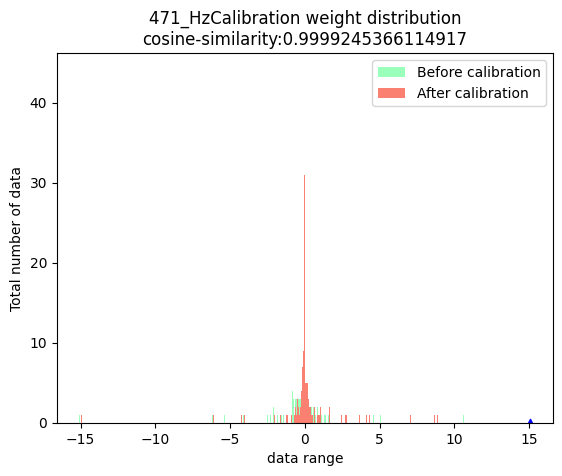
activation:
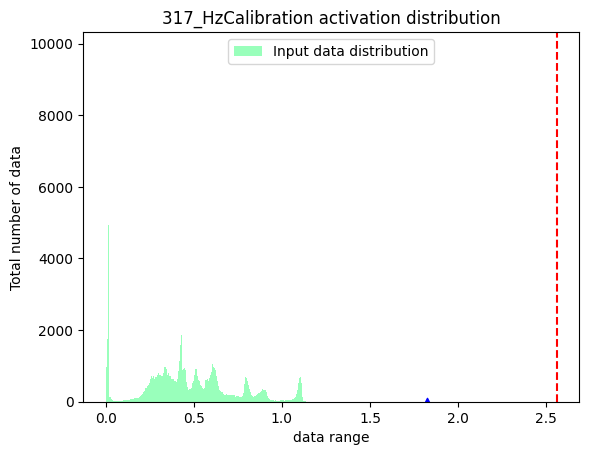
注意:
上方
get_channelwise_data_distribution
功能:绘制
命令行
hmct-debugger get-channelwise-data-distribution MODEL_OR_FILE CALIBRATION_DATA --other options
可hmct-debugger get-channelwise-data-distribution -h/--help 查看
参数
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
save_dir 或 -s |
参数 参数 |
取值 默认 |
可 |
model_or_file |
参数 参数 |
取值 默认 |
必选 |
calibrated_data |
参数 参数 |
取值 默认 |
必选 |
nodes_list 或 -n |
参数 参数 |
取值 默认 |
必选 |
axis 或 -a |
参数 参数 |
取值 默认 |
可 |
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.get_channelwise_data_distribution(
        save_dir: str,
        model_or_file: ModelProto or str,
        calibrated_data: str or CalibrationDataSet,
        nodes_list: List[str],
        axis: int = None)
分析
描述:针对
权重
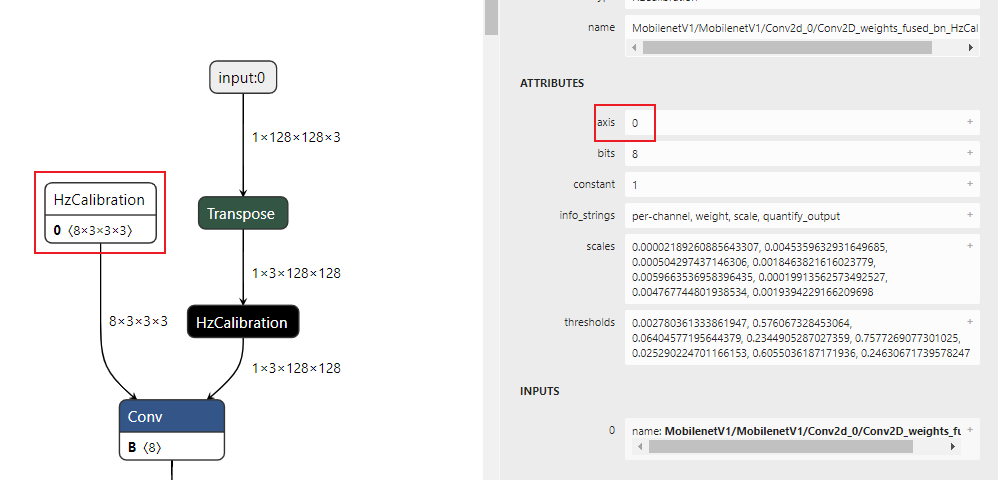
激活
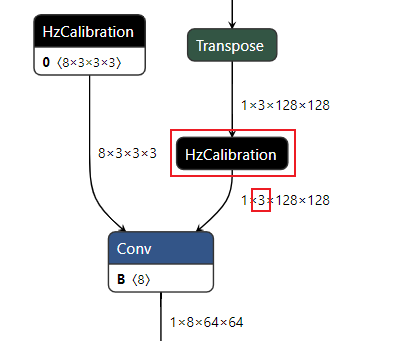
输出
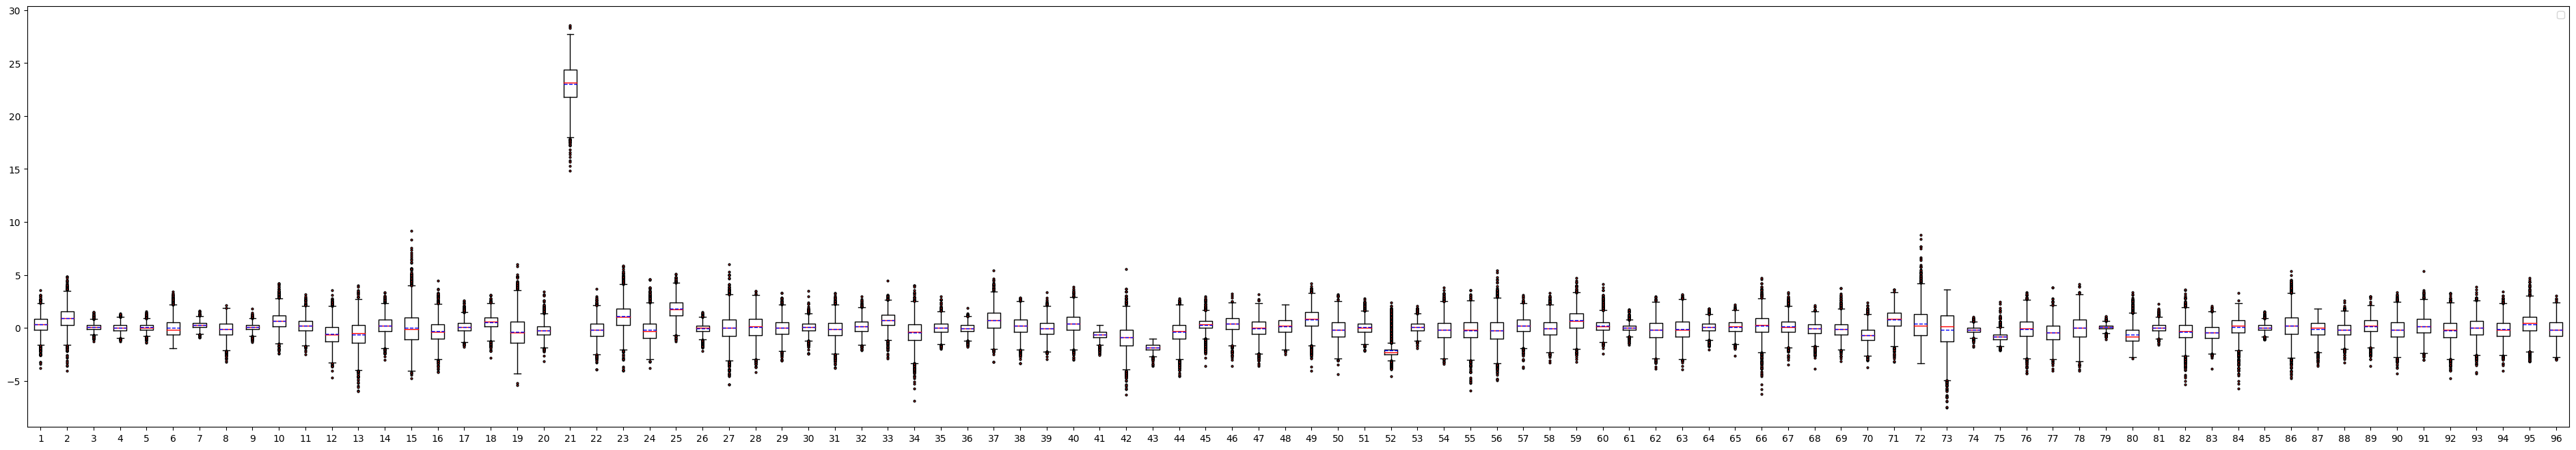
图中:
横坐标
表示 节点 输入 数据 的 通道 数,图例 中 输入 数据 有96个 通道。 纵坐标
表示 每个channel的 数据分布 范围,其中 红色 实线 表示 该channel数据 的 中位数,蓝色 虚线 表示 均值。
sensitivity_analysis
功能:针对
命令行
hmct-debugger sensitivity-analysis MODEL_OR_FILE CALIBRATION_DATA --other options
可hmct-debugger sensitivity-analysis -h/--help 查看
参数
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
model_or_file |
参数 参数 |
取值 默认 |
必选 |
calibrated_data |
参数 参数 |
取值 默认 |
必选 |
pick_threshold 或 -p |
参数 参数 |
取值 默认 |
可 |
data_num 或 -d |
参数 参数 |
取值 默认 |
可 |
sensitive_nodes 或 -sn |
参数 参数 |
取值 默认 |
可 |
save_dir 或 -sd |
参数 参数 |
取值 默认 |
可 |
API使用
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.sensitivity_analysis(model_or_file='calibrated_model.onnx',
                          calibrated_data='calibration_data',
                          pick_threshold=0.9999,
                          data_num=1,
                          sensitive_nodes=[])
命令行
hmct-debugger sensitivity-analysis calibrated_model.onnx calibration_data
分析
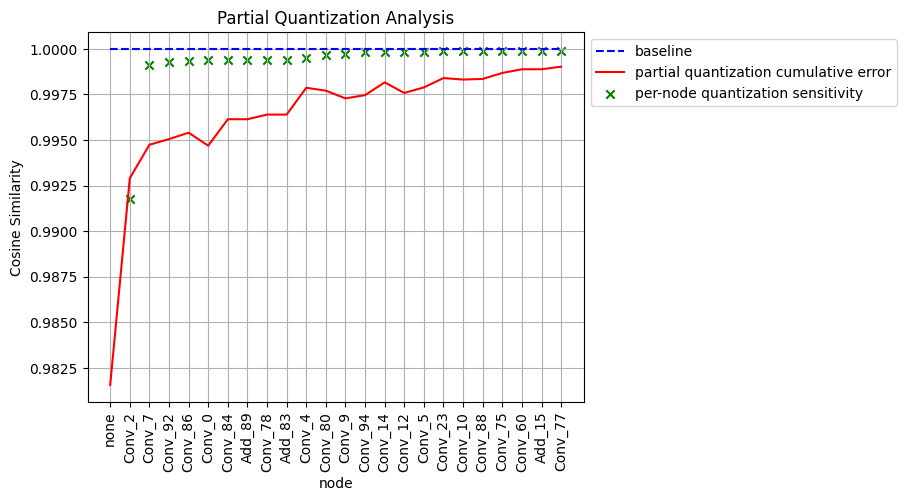
图中:
蓝色
虚线:baseline,即 浮点 模型 输出 与 自身 的 余弦 相似 度,为1。 绿色x :只
量化 当前 节点 得到 部分 量化 模型,计算 部分 量化 模型 与 浮点 模型 最终 输出 的 相似 度。 红色
实线:不 量化 当前 节点 以及 当前 节点 前 的 所有 节点,计算 部分 量化 模型 与 浮点 模型 最终 输出 的 相似 度。例如:上 图 中 Conv_92对应 的 相似 度 数值 大概 在0.995左右,表明 解除Conv_2、Conv_7和Conv_92节点 的 量化 并 保持 其余 所有 节点 量化 得到 部分 量化 模型,该 部分 量化 模型 的 最终 输出 与 浮点 模型 的 最终 输出 之间 的 余弦 相似 度为0.995左右。 横坐标 第一个none,在 红色 实线 中 的 含义 为calibrated_model。
runall
注意:
当前
功能:一键
命令行
hmct-debugger runall MODEL_OR_FILE CALIBRATION_DATA --other options
可hmct-debugger runall -h/--help 查看
参数
| 参数 |
参数 |
取值 |
可 |
|---|---|---|---|
model_or_file |
参数 参数 |
取值 默认 |
必选 |
calibrated_data |
参数 参数 |
取值 默认 |
必选 |
save_dir 或 -s |
参数 参数 |
取值 默认 |
可 |
ns_metrics 或 -nm |
参数 参数 |
取值'cosine-similarity' , 'mse' , 'mre' , 'sqnr' , 'chebyshev' 。默认 'cosine-similarity'。 |
可 |
output_node 或 -o |
参数 参数 |
取值 默认 |
可 |
node_type 或 -nt |
参数 参数 |
取值'node' , 'weight' , 'activation'。默认 'node'。 |
可 |
data_num 或 -dn |
参数 参数 |
取值 默认 |
可 |
verbose 或 -v |
参数 参数 |
取值True 、 False。默认 False。 |
可 |
interested_nodes 或 -i |
参数 参数 |
取值 默认 |
可 |
dis_nodes_list 或 -dnl |
参数 参数 若nodes_list中 - 权重 - 激活 - 普通 注:nodes_list为 list 类型,可 |
取值 默认 |
可 |
cw_nodes_list 或 -cn |
参数 参数 |
取值 默认 |
可 |
axis 或 -a |
参数 参数 |
取值 默认 |
可 |
quantize_node 或 -qn |
参数 参数 通过 例如: - quantize_node=['Conv_2','Conv_9']:分别 - quantize_node=[['Conv_2'],['Conv_9','Conv_2']]:只 - quantize_node 包含 当: - quantize_node = ['weight']:只 - quantize_node = ['activation']:只 - quantize_node = ['weight','activation']:权重 注:quantize_node和non_quantize_node不可 |
取值 默认 |
可 |
non_quantize_node 或 -nqn |
参数 参数 通过 例如: - non_quantize_node=['Conv_2','Conv_9']:分别 - non_quantize_node=[['Conv_2'],['Conv_9','Conv_2']]:只 注:quantize_node和non_quantize_node不可 |
取值 默认 |
可 |
ae_metric 或 -am |
参数 参数 |
取值'cosine-similarity' , 'mse' , 'mre' , 'sqnr' , 'chebyshev' 默认 'cosine-similarity'。 |
可 |
average_mode 或 -avm |
参数 参数 |
取值True 、 False。默认 False。 |
可 |
pick_threshold 或 -pt |
参数 参数 |
取值 默认 |
可 |
sensitive_nodes 或 -sn |
参数 参数 |
取值 默认 |
可 |
API使用
# 导入debug模块
import horizon_nn.quantizer.debugger as dbg

dbg.runall(model_or_file='calibrated_model.onnx',
            calibrated_data='calibration_data')
命令行
hmct-debugger runall calibrated_model.onnx calibration_data
runall流程:
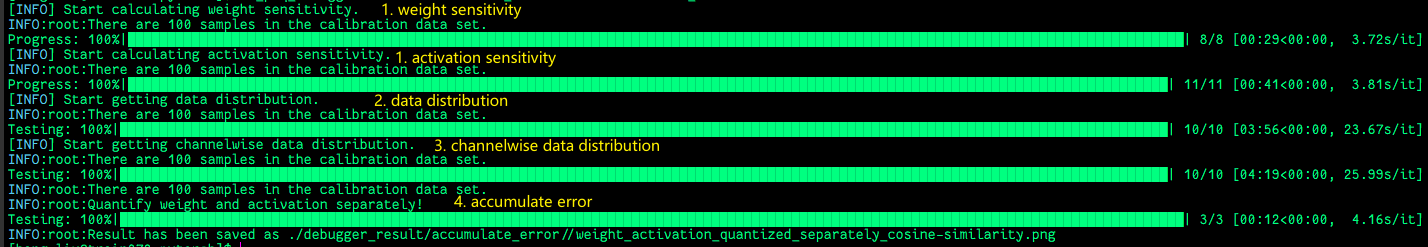
当
step1和step2:分别
获取 权重 校准 节点 和 激活 校准 节点 的 量化 敏感度。 step3:根据step1和step2的
结果,分别 取 权重 校准 节点 的top5和 激活 校准 节点 的top5绘制 其 数据分布。 step4:针对step3获取
的 节点,分别 绘制 其 通道 间 数据分布 的 箱 线图。 step5:绘制
分别 只 量化 权重 和 只 量化 激活 的 累积 误差 曲线。 step6:针对
敏感 节点 进行 部分 量化 以及 单 节点 量化 精度 分析,由于 图中 示例 并 没有 指定sensitive_nodes,因此 需要debug工具 自行 计算 普通 节点 的 量化 敏感度 并 选取 敏感度 小于 指定pick_threshold的 节点 进行 测试 分析。
当node_type='node' 时,工具
6.3.2.7. 使用QAT量化感知训练方案进一步提升模型精度
如果
Horizon Plugin Pytorch参考QAT 相关
更
根据以往的使用调优经验,以上策略已经可以应对各种实际问题。
如果
6.3.2.8. 其它工具使用说明
本
hb_mapper infer
hb_perf
hb_pack
hb_model_info
hb_model_modifier
hb_verifier
hb_eval_preprocess
HB_ONNXRuntime推理
库
hb_mapper infer 工具
注意:
hb_mapper infer 受 onnxruntime 限制,不
支持 动态 的shape infer,因此 要求 输入 的 模型shape信息 明确。 该
工具 不 支持 infer 含有 shape信息 为 ? 的 模型。 该
工具 仅 支持 输入 为 四维 且 输出 小于 等于 四维 的 非featuremap模型。
该--output-dir 指定
为了layer_out_dump 设置True,它
使用
方法
hb_mapper infer的
  hb_mapper infer --config ${config_file} \
                  --model-file ${quantized_model_file}  \
                  --model-type ${caffe/onnx} \
                  --image-file ${input_node} ${image_file} \
                  --input-layout ${input_layout} \
                  --output-dir ${quantized_output_dir}
在hb_mapper infer 命令hb_mapper makertbin 命令hb_mapper makertbin 时hb_mapper infer 时
注意:
您hb_mapper infer 命令
1.preprocess_on: True,则input_type_rt 的
2.preprocess_on: False,则
命令行
参数 -h, –help 显示
帮助 信息 并 退出。 -c, –config 模型
编译 时 的 配置文件。 –model-file 进行
推理 的 模型 文件,可以 是 浮点 和 量化ONNX模型。 –model-type 指定
推理 的 原始 浮点 模型 类型,可 指定 为 caffe或onnx。–image-file 输入
节点 名称 和 其 对应 的 用于 推理 的 图像文件。 –input-layout 模型
输入 的layout(此 为 可 选 参数)。 –output-dir 推理
结果 的 保存 路径,如果 是 量化 模型,推理 结果 为 反 量化 的 浮点 数据。
输出output_dir 目录${layername}_float.bin。
hb_perf 工具
hb_perf 是
使用
方法
hb_perf [OPTIONS] BIN_FILE
命令行
参数
hb_perf的
–version
显示
-m
后接
–help
显示
输出
内容 说明
模型hb_perf_result 文件夹html 文件
  hb_perf_result/
  └── mobilenetv1
      ├── mobilenetv1
      ├── mobilenetv1.html
      ├── mobilenetv1.png
      ├── MOBILENET_subgraph_0.html
      ├── MOBILENET_subgraph_0.json
      └── temp.hbm
若该compiler_parameters.debug:True) 则 hb_perf 工具
2021-01-12 10:41:40,000 WARNING bpu model don't have per-layer perf info.
2021-01-12 10:41:40,000 WARNING if you need per-layer perf info please enable[compiler_parameters.debug:True] when use makertbin.
hb_pack 工具
hb_pack 是
使用
方法
hb_pack [OPTIONS] BIN_FILE1 BIN_FILE2 BIN_FILE3 -o comb.bin
命令行
参数
hb_pack的
–version
显示
-o, –output_name
pack模型
–help
显示
输出
内容 说明
打包output_name 指定hb_model_info 及 hb_perf 获取
注意:
注意,hb_pack 不
ERROR exception in command: pack
ERROR model: xxx.bin is a packed model, it can not be packed again!
hb_model_info 工具
hb_model_info 是
使用
方法
hb_model_info ${model_file}
命令行
参数
hb_model_info的
–version
显示
-m
后接
–help
显示
输出
内容 说明
输出
备注:
以下
Start hb_model_info....
hb_model_info version 1.3.35
******** efficient_det_512x512_nv12 info *********
############# model deps info #############
hb_mapper version   : 1.3.35
hbdk version        : 3.23.3
hbdk runtime version: 3.13.7
horizon_nn version  : 0.10.10
############# model_parameters info #############
onnx_model          : /release/01_common/model_zoo/mapper/detection/efficient_det/efficientdet_nhwc.onnx
BPU march           : bernoulli2
layer_out_dump      : False
working dir         : /release/04_detection/05_efficient_det/mapper/model_output
output_model_file_prefix: efficient_det_512x512_nv12
############# input_parameters info #############
------
---------input info : data ---------
input_name          : data
input_type_rt       : nv12
input_space&range   : regular
input_layout_rt     : None
input_type_train    : rgb
input_layout_train  : NCHW
norm_type           : data_mean_and_scale
input_shape         : 1x3x512x512
mean_value          : 123.68,116.779,103.939,
scale_value         : 0.017,
cal_data_dir        : /release/04_detection/05_efficient_det/mapper/calibration_data_rgb_f32
---------input info : data end -------
------
############# calibration_parameters info #############
preprocess_on       : False
calibration_type    : max
############# compiler_parameters info #############
hbdk_pass_through_params: --fast --O3
input-source        : {'data': 'pyramid', '_default_value': 'ddr'}
--------- input/output types -
model input types   : [<InputDataType.NV12: 7>]
model output types  : [<InputDataType.F32: 5>, <InputDataType.F32: 5>, <InputDataType.F32: 5>, <InputDataTye.F32: 5>, <InputDataType.F32: 5>, <InputDataType.F32: 5>, <InputDataType.F32: 5>, <InputDataType.F32: 5>, <InputDataType.F32: 5>, <InpuDataType.F32: 5>]
备注:
当deleted_nodes_info.txt 文件,文件
--------- deleted nodes -
deleted nodes: spconvretinanethead0_conv91_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv95_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv99_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv103_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv107_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv93_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv97_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv101_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv105_fwd_chw_HzDequantize
deleted nodes: spconvretinanethead0_conv109_fwd_chw_HzDequantize
hb_model_modifier 工具
hb_model_modifier 工具*.bin 模型hb_model_info 进行
备注:
hb_model_modifier工具
只能 删除 紧 挨着 模型 输入 或 输出 的 节点。如果 待 删除 节点 后面 接 的 是 其他 节点,则 不能 进行 删除 操作。 模型
节点 名称 需要 注意 不要 包括 “;” “,” 等 特殊符号,否则 可能 会 影响 工具 的 使用。 工具
不 支持 对 打包 的 模型 进行 处理,否则 将 提示: ERROR pack model is not supported。待
删除 节点 会 按 顺序 依次 删除, 并且 会 动态 更新 模型 结构; 同时 在 节点 删除 前 还 会 判断 该 节点 是否 位于 模型 的 输入输出 处, 因此 节点 的 删除 顺序 很 重要。
由于
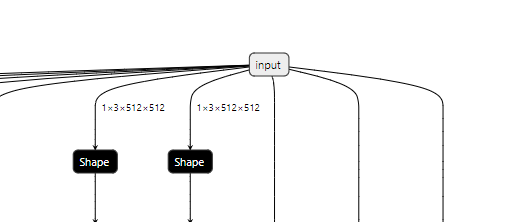
使用
方式
1.查看
hb_model_modifier model.bin
2.删除
hb_model_modifier model.bin -r node1
3.删除
hb_model_modifier model.bin -r node1 -r node2 -r node3
4.删除
hb_model_modifier model.bin --all Dequantize
5.删除
hb_model_modifier model.bin -a Reshape -a Cast -a Dequantize
6.组合
hb_model_modifier model.bin -a Reshape -a Cast -a Dequantize -r node1 -r node2 -r node3
命令行
参数
hb_model_modifier的
–model_file
runtime 模型
-r
后接
-o
后接-r 参数
-a –all
后接
输出
内容 说明
若
其中Quantize节点
qx = clamp(round(x / scale) + zero_point, -128, 127)
round(x) 实现clamp(x) 函数zero_point 为zero_point = 0 。
C++的
  int64_t quantized_value =
      static_cast<int64_t>(std::round(value / static_cast<double(scale)));
  quantized_value = std::min(std::max(quantized_value, min_int_value), max_int_value);
Dequantize节点int8 或 int32 类型float 或 double 类型,其
deqx = (x - zero_point) * scale
C++的
static_cast<float>(value) * scale
备注:
目前
输入
部位 的 节点 为Quantize或Transpose节点; 输出
部位 的 节点 为Transpose、Dequanti、Cast、Reshape、Softmax节点。
工具
hb_model_modifier resnet50_64x56x56_featuremap.bin
2022-04-21 18:22:30,207 INFO Nodes that can be deleted: ['data_res2a_branch1_HzQuantize_TransposeInput0', 'fc1000_reshape_0']
在-r 选项
hb_model_modifier resnet50_64x56x56_featuremap.bin -r data_res2a_branch1_HzQuantize_TransposeInput0
Node 'data_res2a_branch1_HzQuantize_TransposeInput0' found, its OP type is 'Transpose'
Node 'data_res2a_branch1_HzQuantize_TransposeInput0' is removed
modified model saved as resnet50_64x56x56_featuremap_modified.bin
之后hb_model_info 工具deleted_nodes_info.txt 文件,文件
hb_model_info resnet50_64x56x56_featuremap_modified.bin
Start hb_model_info....
hb_model_info version 1.7.0
********* resnet50_64x56x56_featuremap info *********
...
--------- deleted nodes -
deleted nodes: data_res2a_branch1_HzQuantize_TransposeInput0
hb_verifier 工具
hb_verifier 工具
若hb_verifier 工具
该hrt_tools, 若无则package/board 下install.sh 脚本hrt_tools,
若无则package/host 下install.sh 脚本
注意:
package资料包 获取 方式,请 参考交付 物 。使用 说明 hb_verifier工具
不 支持 除Dequantize节点 外,有 其他 节点 变化 的bin模型 与quanti.onnx进行 对比。 如果
在 使用 本 工具 前,您 使用hb_model_modifier工具 删除 了bin模型 的 输出 前 的 最后 一个 节点 且 该 节点 为 非Dequantize节点,或者yaml文件 中 配置 了 remove_node_type参数, 从而删除 了bin模型 的 输出 前 的 最后 一个 节点 且 该 节点 为 非Dequantize节点,那么hb_verifier工具 将 不再 支持quanti.onnx和 删除 节点 后 的bin模型 做 对比。 如
您 想 解决 上述 问题,需要 避免出现 上述 删除bin模型 的 输出 前 的 最后 一个 节点 且 该 节点 为 非Dequantize节点 的 情况。 由于hb_verifier工具
与 板端 通过SSH进行 交互,故如 您 在Docker容器 内 使用 本 工具,请勿 使用 docker attach命令连接 容器,使用 此 命令 连接 容器 会 导致 与 板端 交互 的SSH认证 失败。
使用
方式
hb_verifier -m   ${quanti_model},${bin_model} \
            -b   ${board_ip} \
            -s   True / False \
            -i   ${input_img} \
            -c   ${digits}  \
            -r   True / False
            -u   Board username
            -p   Board password
命令行
参数
hb_verifier的
–version
显示
-h, –help
显示
-m, –model
定点
-b, –board-ip
上板
-s, –run-sim
设置
- 当该参数设置为 ``True`` 时,工具将会使用x86环境的libdnn做bin模型推理。

- 当该参数设置为 ``False`` 时,工具不会使用x86环境的libdnn做bin模型推理。
-i, –input-img
指定
若不指定则会使用随机生成的tensor数据。

若指定图片为二进制形式的图片文件,其文件形式需要为后缀名为 ``.bin`` 形式。

多输入模型添加图片的方式有以下两种传参方式,多张图片之间用","分割:

- input_name1:image1,input_name2:image2, ...

- image1,image2...
注意: 在
-c, –compare_digits
设置
-r, –dump-all-nodes-results
设置
- 当该参数设置为 ``True`` 时,工具将会获取模型中所有节点的输出,并根据节点输出的名字做匹配,从而进行对比。

- 当该参数设置为 ``False`` 时,工具将会只获取模型最终输出的结果,并进行对比。
注意: 请
-u, –username
用于root 。
-p, –password
如
注意: 如所
参考
使用 场景 样例
1.quanti.onnx模型
hb_verifier -m quanti.onnx,model.bin -b *.*.*.* -s True (-i 选填)
2.quanti.onnx模型
hb_verifier -m quanti.onnx,model.bin -b *.*.*.* (-i 选填)
3.quanti.onnx模型
hb_verifier -m quanti.onnx,model.bin -b *.*.*.* -r True (-i 选填)
4.quanti.onnx模型
hb_verifier -m quanti.onnx,model.bin -s True (-i 选填)
输出
内容 说明
结果
  Comparison results of original output is model_infer_output_0
  raw output 0 and raw output 0 result Strict check PASSED
  Quanti.onnx and Arm result Strict check PASSED
在
  INFO ================== Sim infer log end ==========================
  INFO ***************************************************************
  INFO compare source: Quanti.onnx VS Arm
  INFO compare model name: clr_320x800_bgr_quantized_model VS clr_320x800_bgr
  Compare progress: 100%|###########################| 1/1 [00:00<00:00, 55.47it/s]
  INFO =============== Original output comparison results =================
  INFO Comparison results of original output is model_infer_output_0_output
  INFO mismatch result num: 1000
  INFO total result num: 1000
  INFO mismatch rate: 1.0
  INFO relative mismatch ratio: 0.9997149805034536
  INFO max abs error: 8.36695
  WARNING raw output output and raw output output result Strict check FAILED
  WARNING Quanti.onnx and Arm result Strict check FAILED
  INFO ***************************************************************
  INFO ***************************************************************
  INFO compare source: Quanti.onnx VS Sim
  INFO compare model name: clr_320x800_bgr_quantized_model VS clr_320x800_bgr
  Compare progress: 100%|##########################| 1/1 [00:00<00:00, 135.53it/s]
  INFO =============== Original output comparison results =================
  INFO Comparison results of original output is model_infer_output_0_output
  INFO mismatch result num: 1000
  INFO total result num: 1000
  INFO mismatch rate: 1.0
  INFO relative mismatch ratio: 0.9997149805034536
  INFO max abs error: 8.36695
  WARNING raw output output and raw output output result Strict check FAILED
  WARNING Quanti.onnx and Sim result Strict check FAILED
  INFO ***************************************************************
  INFO ***************************************************************
  INFO compare source: Arm VS Sim
  INFO compare model name: clr_320x800_bgr VS clr_320x800_bgr
  Compare progress: 100%|##########################| 1/1 [00:00<00:00, 150.69it/s]
  INFO Arm and Sim result Strict check PASSED
  INFO ***************************************************************
其中:
mismatch result num为两种 模型 精度 不 一致 结果 的 个数,包括 三种 不 一致 情况: mismatch.line_miss num为输出 结果 数量 不 一致 的 个数。 mismatch.line_diff num为输出 结果 差距 过大 的 个数。 mismatch.line_nan num为输出 为nan的 个数。
total result num为输出 数据 的 总 个数。 mismatch rate为不 一致 数据 个数 占 输出 数据 总 个数 的 比例。 relative mismatch ratio为相对误差 比例,取 误差 比例 最大 的 值 进行 展示。 max abs error为最大 绝对误差。
hb_eval_preprocess 工具
用于
使用
方法
hb_eval_preprocess [OPTIONS]
命令行
参数
hb_eval_preprocess的
–version
显示
-m, –model_name
设置hb_eval_preprocess --help 查看。
-i, –image_dir
输入
-o, –output_dir
输出
-v, –val_txt
设置
-h, –help
显示
输出
内容 说明
hb_eval_preprocess 命令--output_dir 指定
小hb_eval_preprocess 工具
HB_ONNXRuntime 推理库
HB_ONNXRuntime是
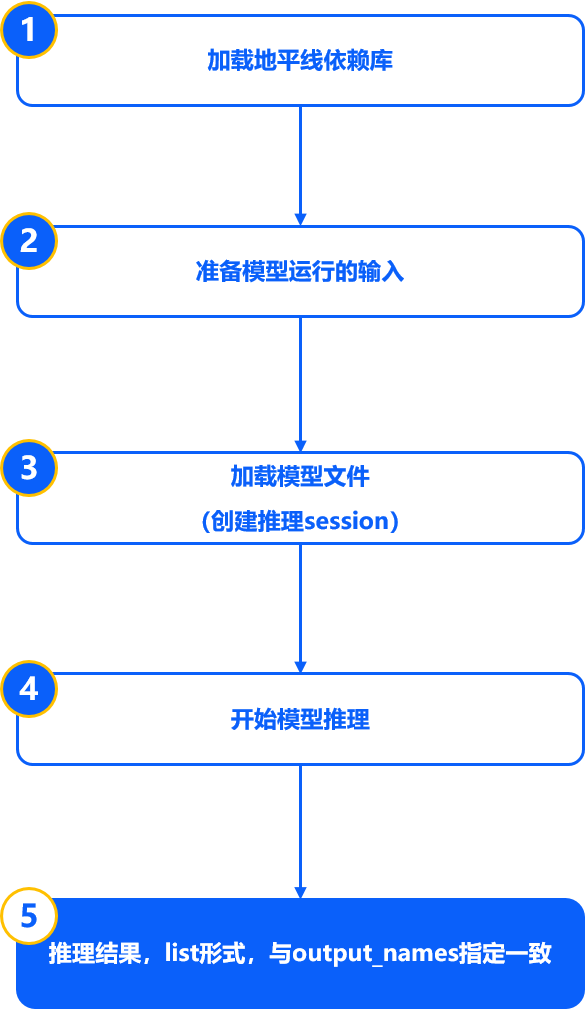
注意:
请
模型
模型
模型
如
使用
方法 使用HB_ONNXRuntime加载ONNX模型
推理 的 基本 流程 如下 所示,这份 示例 代码 适用 于 所有ONNX模型 的 推理, 根据 不同 模型 的 输入 类型 和layout要求 准备 数据 即可:
import numpy as np
# 加载地瓜依赖库
from horizon_tc_ui import HB_ONNXRuntime
# 准备模型运行的输入
input_data = np.load("input.npy")
# 加载模型文件
sess = HB_ONNXRuntime(model_file = "model.onnx")
# 获取模型输入&输出节点信息
input_names = sess.input_names
output_names = sess.output_names
# 准备输入数据,这里我们假设此模型只有1个输入
input_info = {input_names[0]: input_data}
# 开始模型推理,推理的返回值是一个list,依次与output_names指定名称一一对应
output = sess.run(output_names, input_info)
参数
说明
output_names:
用于
如
如
input_info:
按照