5.1. 嵌入式应用开发指导
5.1.1. 概述
本章节介绍如何在地瓜机器人平台进行应用开发,将经过转换后的模型部署到开发板上运行起来,需要您注意的相关注意事项在此章节也会介绍。
注意
在开始开发应用前,请确保您已经根据 环境部署 章节的内容完成了开发环境准备。
最简易的开发过程包括工程创建、工程实现、工程编译与运行三个阶段。 考虑到实际业务场景开发的较复杂需求,对于常用的多模型控制概念和应用调优建议也都提供了一些说明。
5.1.2. 工程创建
地瓜机器人推荐使用 cmake 进行应用工程管理,前文介绍的环境部署部分也已经完成了 cmake 安装。 在阅读本节内容前,我们希望您已经了解 cmake 的使用。
地瓜机器人开发库提供了 arm 的依赖环境和板端应用程序。我们在 Docker 镜像中提供的工程依赖信息如下:
地瓜机器人评测库 libdnn.so,路径:
~/.horizon/ddk/xj3_aarch64/dnn/lib/。地瓜机器人编译器依赖 libhbrt_bernoulli_aarch64.so,路径:
~/.horizon/ddk/xj3_aarch64/dnn/lib/。c 编译器 aarch64-linux-gnu-gcc。
c++编译器 aarch64-linux-gnu-g++。
创建一个工程用户需要编写 CMakeLists.txt 文件。 脚本中定义了编译工具路径,CMakeLists.txt 文件中定义了一些编译选项,以及依赖库、头文件的路径。参考如下:
cmake_minimum_required(VERSION 2.8)

project(your_project_name)

# libdnn.so depends on system software dynamic link library, use -Wl,-unresolved-symbols=ignore-in-shared-libs to shield during compilation
set(CMAKE_CXX_FLAGS "${CMAKE_CXX_FLAGS} -std=c++11 -Wl,-unresolved-symbols=ignore-in-shared-libs")

set(CMAKE_CXX_FLAGS_DEBUG " -Wall -Werror -g -O0 ")
set(CMAKE_C_FLAGS_DEBUG " -Wall -Werror -g -O0 ")
set(CMAKE_CXX_FLAGS_RELEASE " -Wall -Werror -O3 ")
set(CMAKE_C_FLAGS_RELEASE " -Wall -Werror -O3 ")

if (NOT CMAKE_BUILD_TYPE)
    set(CMAKE_BUILD_TYPE Release)
endif ()

message(STATUS "Build type: ${CMAKE_BUILD_TYPE}")

# define dnn lib path
set(DNN_PATH "~/.horizon/ddk/xj3_aarch64/dnn/")

set(DNN_LIB_PATH ${DNN_PATH}/lib)

include_directories(${DNN_PATH}/include)
link_directories(${DNN_LIB_PATH})

add_executable(user_app main.cc)
target_link_libraries(user_app
                      dnn
                      pthread
                      rt
                      dl)
注意在以上示例中,我们没有指定编译器位置,会在配合工程编译阶段补充编译器指定, 请参考 工程编译与运行 小节部分的介绍。
5.1.3. 工程实现
工程实现部分,我们主要为您介绍如何将前文浮点转换得到的 bin 模型在地瓜机器人平台运行起来。 最简单的步骤应该包括模型加载、准备输入数据、准备输出内存、推理和结果解析,以下是一份简单的加载部署模型参考代码:
#include <iostream>

#include "dnn/hb_dnn.h"
#include "dnn/hb_sys.h"

int main(int argc, char **argv) {
  // 第一步加载模型
  hbPackedDNNHandle_t packed_dnn_handle;
  const char* model_file_name= "./mobilenetv1.bin";
  hbDNNInitializeFromFiles(&packed_dnn_handle, &model_file_name, 1);

  // 第二步获取模型名称
  const char **model_name_list;
  int model_count = 0;
  hbDNNGetModelNameList(&model_name_list, &model_count, packed_dnn_handle);

  // 第三步获取dnn_handle
  hbDNNHandle_t dnn_handle;
  hbDNNGetModelHandle(&dnn_handle, packed_dnn_handle, model_name_list[0]);

  // 第四步准备输入数据
  hbDNNTensor input;
  hbDNNTensorProperties input_properties;
  hbDNNGetInputTensorProperties(&input_properties, dnn_handle, 0);
  input.properties = input_properties;
  auto &mem = input.sysMem[0];

  int yuv_length = 224 * 224 * 3;
  hbSysAllocCachedMem(&mem, yuv_length);
  //memcpy(mem.virAddr, yuv_data, yuv_length);
  //hbSysFlushMem(&mem, HB_SYS_MEM_CACHE_CLEAN);

  // 第五步准备模型输出数据的空间
  int output_count;
  hbDNNGetOutputCount(&output_count, dnn_handle);
  hbDNNTensor *output = new hbDNNTensor[output_count];
  for (int i = 0; i < output_count; i++) {
  hbDNNTensorProperties &output_properties = output[i].properties;
  hbDNNGetOutputTensorProperties(&output_properties, dnn_handle, i);

  // 获取模型输出尺寸
  int out_aligned_size = 4;
  for (int j = 0; j < output_properties.alignedShape.numDimensions; j++) {
    out_aligned_size =
        out_aligned_size * output_properties.alignedShape.dimensionSize[j];
  }

  hbSysMem &mem = output[i].sysMem[0];
  hbSysAllocCachedMem(&mem, out_aligned_size);
}

  // 第六步推理模型
  hbDNNTaskHandle_t task_handle = nullptr;
  hbDNNInferCtrlParam infer_ctrl_param;
  HB_DNN_INITIALIZE_INFER_CTRL_PARAM(&infer_ctrl_param);
  hbDNNInfer(&task_handle,
              &output,
              &input,
              dnn_handle,
              &infer_ctrl_param);

  // 第七步等待任务结束
  hbDNNWaitTaskDone(task_handle, 0);
  //第八步解析模型输出,例子就获取mobilenetv1的top1分类
  float max_prob = -1.0;
  int max_prob_type_id = 0;
  hbSysFlushMem(&(output->sysMem[0]), HB_SYS_MEM_CACHE_INVALIDATE);
  float *scores = reinterpret_cast<float *>(output->sysMem[0].virAddr);
  int *shape = output->properties.validShape.dimensionSize;
  for (auto i = 0; i < shape[1] * shape[2] * shape[3]; i++) {
    if(scores[i] < max_prob)
      continue;
    max_prob = scores[i];
    max_prob_type_id = i;
  }

  std::cout << "max id: " << max_prob_type_id << std::endl;
  // 释放内存
  hbSysFreeMem(&(input.sysMem[0]));
  hbSysFreeMem(&(output->sysMem[0]));

  // 释放模型
  hbDNNRelease(packed_dnn_handle);

  return 0;
}
示例代码中,为了缩减篇幅,对于部分数据就直接使用了已知的常数。
在实际使用过程中,您应该通过 hbDNNGetInputTensorProperties/hbDNNGetOutputTensorProperties 等接口获取尺寸和数据类型等信息。
需要您注意的是,在输入数据准备阶段,我们注释掉了一段 memcpy 代码。
这里应当是根据模型的输入格式要求准备输入样本,并将其拷贝到 input.sysMem[0] 中。
转换配置中的 input_type_rt 和 input_layout_rt 参数共同决定了模型使用什么样的输入,
具体信息可以参考 转换内部过程解读 部分的介绍。
更加全面的工程实现指导请阅读 BPU SDK API 手册 。
5.1.4. 工程编译和运行
您需要根据目标平台的 GCC 环境,指定环境变量 LINARO_GCC_ROOT ,以获取正确的交叉编译工具执行编译,例如:
export LINARO_GCC_ROOT=/opt/gcc-ubuntu-9.3.0-2020.03-x86_64-aarch64-linux-gnu
export LINARO_GCC_ROOT=/opt/gcc-linaro-6.5.0-2018.12-x86_64_aarch64-linux-gnu
注解
环境变量 LINARO_GCC_ROOT 的设置路径需要与交叉编译工具解压的目录相同,否则会导致失败。
结合 工程创建 一节中的 cmake 工程配置,参考如下编译脚本:
DIR=$(cd "$(dirname "$0")";pwd)

export CC=${LINARO_GCC_ROOT}/bin/aarch64-linux-gnu-gcc
export CXX=${LINARO_GCC_ROOT}/bin/aarch64-linux-gnu-g++

rm -rf build_arm
mkdir build_arm
cd build_arm

cmake ${DIR}

make -j8
根据 环境部署 部分的指引,您的开发机中应该已经安装有相应编译器,将上述脚本中的编译器配置指定为您的安装项目即可。
arm 程序拷贝到地瓜机器人开发板上可运行,注意程序依赖的文件也需要一同拷贝到开发板,并在启动脚本中配置依赖。
例如我们的示例程序依赖库有: libhbrt_bernoulli_aarch64.so、libdnn.so ,
这两个依赖库在本地的位置为: ~/.horizon/ddk/xj3_aarch64/dnn/lib/ ,需要将之上传到板子的运行环境中。
建议在板端的 /userdata 路径下新建 lib 路径并将库传送至该目录下,则在板端运行程序前,需指定的依赖库路径信息如下:
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/userdata/lib
5.1.5. 多模型控制策略
多模型场景中,每个模型都需要使用有限的计算资源完成推理,不可避免地会出现计算资源的争夺情况。 为了便于您控制多模型的执行,地瓜机器人提供了模型优先级的控制策略供您使用。
5.1.5.1. 模型优先级控制
注意
请注意,此功能仅支持在开发板端实现,x86 模拟器不支持此功能。
X3 计算平台 BPU 计算单元硬件本身没有任务抢占功能,对于每一个推理任务,一旦它进到 BPU 模型计算之后,在该任务执行完成之前都会一直占用 BPU, 其他任务只能排队等待。此时很容易出现 BPU 计算资源被一个大模型推理任务所独占,进而影响其他高优先级模型的推理任务执行。 针对这种问题,Runtime SDK 基于模型的优先级通过软件的方式实现了 BPU 资源抢占的功能。
其中有以下点需要被关注:
编译后的数据指令模型在 BPU 上进行推理计算时,它将表现为 1 个或者多个 function-call 的调用,其中 function-call 是 BPU 的执行粒度, 多个 function-call 调用任务将在 BPU 的硬件队列上按序进行调度,当一个模型所有的 function-call 都执行完成, 那么一个模型推理任务也就执行完成了。
基于上述描述,BPU 模型任务抢占粒度设计为 function-call 更为简单,即 BPU 执行完一个 function-call 之后,暂时挂起当前模型, 然后切入执行另外一个模型,当新模型执行完成之后,再恢复原来模型的状态继续运行。 但是这里存在两个问题,第一是经过编译器编译出来的模型 function-call 都是 merge 在一起,此时模型只有一个大的 function-call, 它无法被被抢占;第二是每个 function-call 的执行时间比较长或者不固定,也会造成抢占时机不固定,影响抢占效果。
为了解决上述的两个问题,地瓜机器人在模型编译和系统软件层面都给予了支持,下面分别介绍其实现原理和操作方法:
首先,在 模型转换 阶段,可以在模型的 YAML 配置文件中的编译器相关参数(即
compiler_parameters)中, 通过max_time_per_fc参数(以微秒为单位,默认取值为0,即不做限制。)来设置每个 function-call 的执行时间。 假设某 function-call 执行时间为 10ms,如将其max_time_per_fc设置为500, 则这个 function-call 将会被拆分成 20 个。其次,系统软件层面设计了
BPLAT_CORELIMIT环境变量用于设置可抢占的粒度。 如将此参数设置为2,则高优先级被调度执行的时间为前面 2 个低优先级 function-call 的处理时间。 如果为0,则不抢占。因此,为了尽早执行高优先级的任务,可在 上板 时,先运行export BPLAT_CORELIMIT=1将此环境变量的取值设置为1。 这样当系统底层收到模型的 function-call 时,会判断其优先级,对于优先级高的 function-call 则放入单独队列,以便能够在一个 function-call 执行完成之后,抢占到 BPU 资源。接着,由于模型抢占机制是在 libdnn 中实现的,继续设置
dnn的infer接口提供的hbDNNInferCtrlParam.priority参数 如:配置infer任务为HB_DNN_PRIORITY_PREEMP(255),则为抢占任务,可支持 function-call 级别抢占。
5.1.6. 应用调优建议
地瓜机器人建议的应用调优策略包括工程任务调度和算法任务整合两个方面。
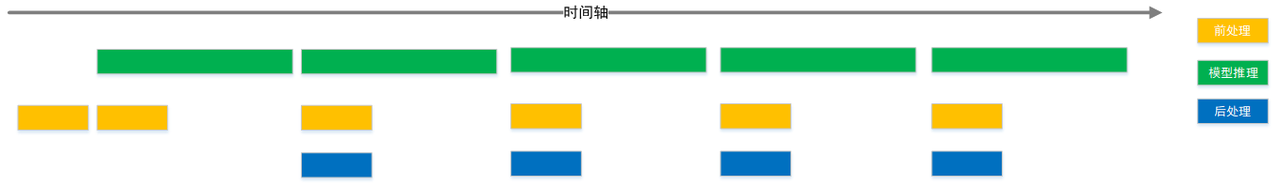
工程任务调度 方面,我们推荐您使用一些 workflow 调度管理工具,充分发挥不同任务阶段的并行能力。 一般应用可以简单拆分为输入前处理、模型推理、输出后处理三个阶段,在简易流程下,其处理流程如下图。

充分利用 workflow 管理实现不同任务阶段并行后,理想的任务处理流程将达到下图效果。
算法任务整合 方面,地瓜机器人推荐您使用多任务模型。 这样一方面可以在一定程度上避免多模型调度管理的困难; 另一方面多任务模型也能充分共享主干网络的计算量,较于使用各个独立的模型,可以在整个应用级别明显减少计算量,从而达到更高的整体性能。 在地瓜机器人内部和许多合作客户的业务实践中,多任务也是常见的应用级优化策略。
5.1.7. 其他应用开发工具
hrt_bin_dump是模型的 layer dump 工具,工具的输出文件为二进制文件,工具使用方法请参考 hrt_bin_dump 工具介绍 。hrt_model_exec是一个模型执行工具,可直接在开发板上评测模型的推理性能、获取模型信息。一方面可以让用户拿到模型时实际了解模型真实性能; 另一方面也可以帮助用户了解模型可以做到的速度极限,对于应用调优的目标极限具有指导意义。hrt_model_exec工具分别提供了模型推理infer、模型性能分析perf和查看模型信息model_info三类功能,工具使用方法请参考 hrt_model_exec 工具介绍 。
5.1.8. 常见问题
5.1.8.1. 如何理解 BPU 内存 Cache?
在 BPU SDK API 手册 中,我们提供了 BPU 内存函数 hbSysAllocCachedMem 和 hbSysAllocMem 来分配 BPU 读写内存。
其中 hbSysAllocCachedMem 表示分配可以被 cache 的内存, 并配套了 hbSysFlushMem 函数来对 Cache 进行刷新。
Cache 机制是由计算平台 BPU 的内存架构来决定的,详细参考如下图所示。 CPU 与主存之间存在的 Cache 会缓存数据,而 BPU 与主存之间则没有 cache。 此时若错误使用 Cache 将会直接影响最终数据读写的准确性和效率。
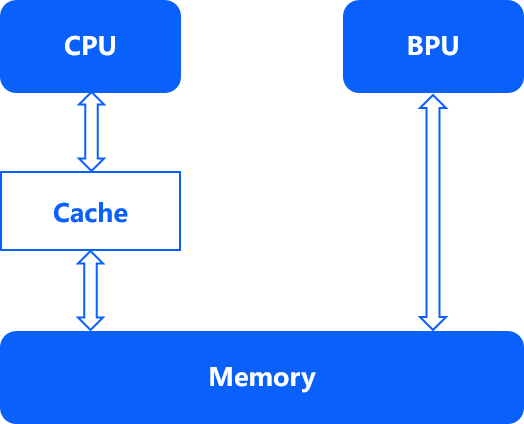
当 CPU 写完数据后,需要主动将 Cache 中的数据 flush 到 memory 中,否则 BPU 会读取到之前的旧数据;
而当 BPU 写完数据后,也需要主动将 Cache 中的数据 invalidate 掉,否则 CPU 会优先读取到之前缓存在 cache 中的旧数据;
在模型连续推理过程中,输入输出建议申请带 Cache 的内存,以加速 CPU 反复读写的效率。
5.1.8.2. 理解 BPU 内存中的物理地址和虚拟地址?
在 X3 计算平台架构中,BPU 和 CPU 内存共享,通过 hbSysAllocCachedMem 和 hbSysAllocMem 接口可以申请到一段物理空间连续的内存,
其函数返回值被包装在 hbSysMem 数据结构体中, phyAddr 和 virAddr 两个字段分别对应其内存空间的物理地址和虚拟地址。
由于这段内存空间是连续的,所以物理地址和虚拟地址都可以通过首地址进行表示和读写。但是在实际使用过程中,建议优先使用虚拟地址,非必须场景请勿直接使用物理地址。
5.1.8.3. 如何将摄像头输出的 NV12 图片转换为 BGR 等格式?
地瓜机器人 X3 计算平台未提供图片像素空间转换的加速硬件,因此地瓜机器人团队有收到一些反馈表示希望通过 API 接口来开放 BPU 对像素空间转换进行加速。 但是为了规避 BPU 的模型推理效率被该功能影响,经过地瓜机器人技术团队缜密评估后,决定暂不对用户开放。
不过在 ARM CPU 上,您也可以利用开源的 libYUV 库来加速该操作。 经过测试验证,720P 的图像,NV12 转 BGR,转换延迟低于 7ms,满足大部分业务场景需求。